Если статью редактировал ИИ, кто её автор?
Мы много говорим об автоматизации. Отделов, процессов, рутинных задач. Это давно никого не удивляет, наоборот, считается правильным подходом: зачем тратить часы на то, что можно сделать быстрее?
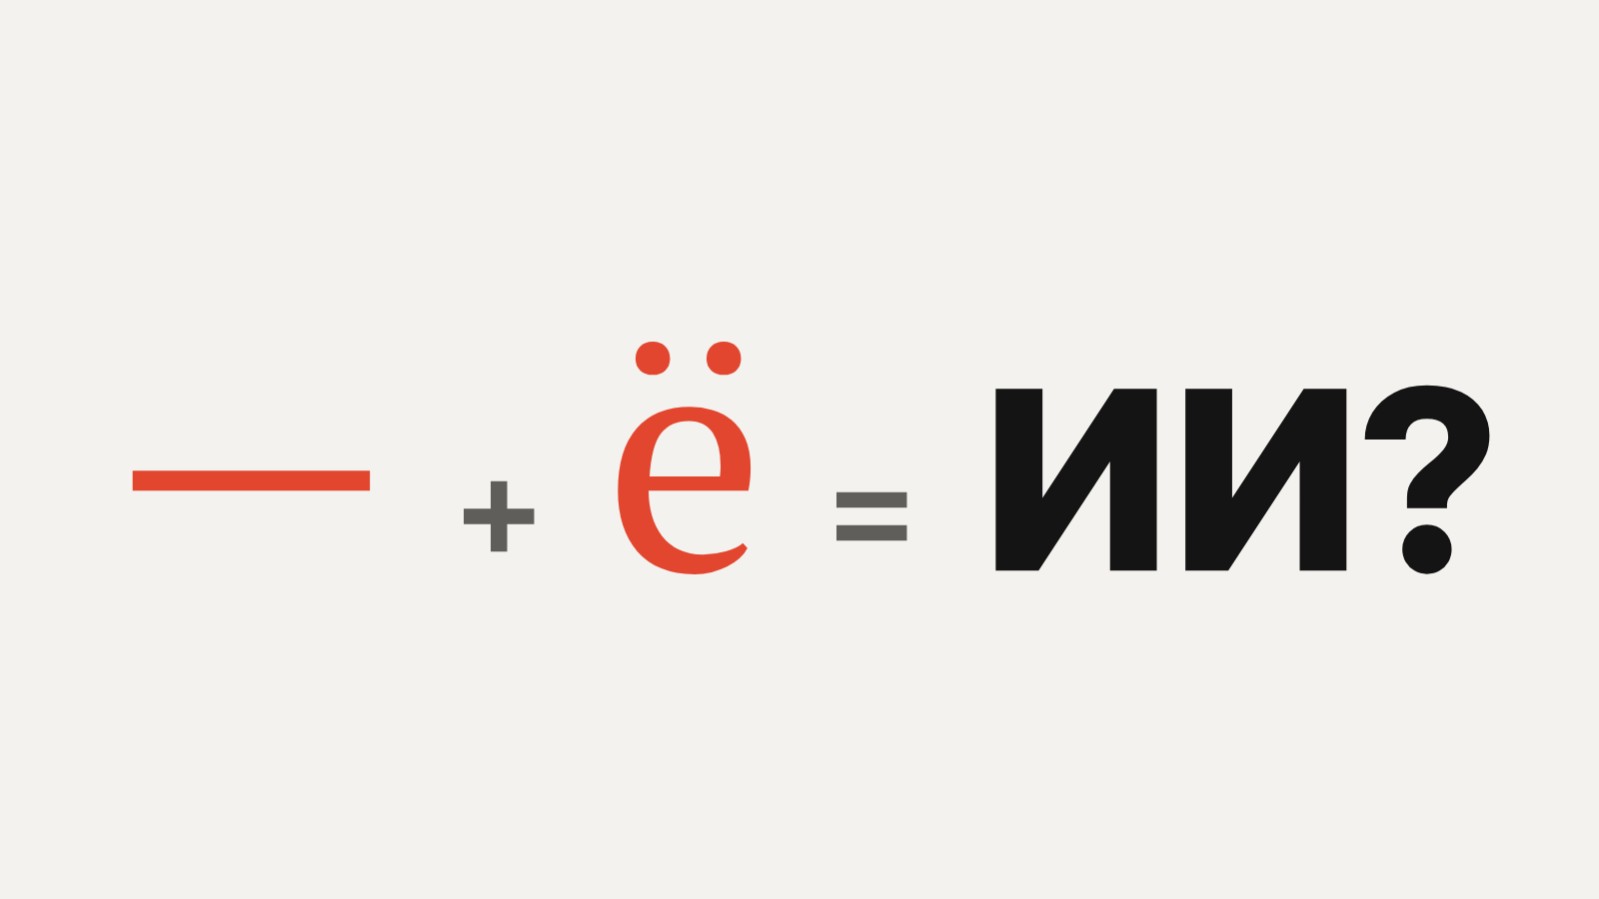
Но стоит заговорить о личном контенте, и всё меняется. Статьи, посты, мнения, авторские работы. Если тут помогал ИИ, это почему-то минус. Как будто текст после этого перестаёт быть авторским. Причём часто судят даже не по содержанию, а по тире, букве «ё» или слишком ровной структуре. Дальше можно не читать.
Скажу честно: мои статьи проходят через ИИ, и я этого не скрываю. Наоборот, считаю, что это заметно экономит время. Но мне захотелось разобраться, что на самом деле делает в тексте нейросеть, а что автор. И почему за формой так легко не заметить содержание.
Что делает автор, пока текста ещё нет
Хорошая экспертная статья начинается задолго до первого абзаца. Нужно снять данные из кабинетов и сравнить периоды. Написать в поддержку и дождаться ответа (иногда не с первого раза). Задать вопрос менеджеру площадки. Проверить гипотезу на реальных кампаниях и подождать результата. Собрать скриншоты, которые подтвердят слова. Покопаться в первоисточниках, чтобы не пересказывать чужие материалы.
А потом начинается самое сложное: решить, что из всего этого вообще можно утверждать. Где данные подтверждают вывод, а где пока только догадка, которую честнее так и назвать. Что можно показать читателю, а что раскрывать нельзя. Какой пример действительно был, а какой просто красиво звучит.
Может ли это сделать нейросеть? Отчасти. Данные из кабинета можно подтянуть по API, хотя я собираю их вручную. Но решить, какие данные нужны, что с чем сравнивать и какую гипотезу проверять, нейросеть за автора не может. Она не знает контекста: что вы пробовали в прошлом месяце, почему это не сработало и о чём стоит спросить поддержку. А именно на эту часть уходит больше всего времени, и от неё зависит, узнает ли читатель из статьи что-то новое.
У меня на сбор данных и сырой текст уходит в среднем от 2 до 8 часов, в зависимости от статьи. И это уже когда понятно, о чём писать. Сколько времени уходит на поиск темы и на то, чтобы понять, что в ней по-настоящему стоит раскрыть, я даже не считаю. Мысль может прийти и в разгар работы, и поздно ночью.
Что делает нейросеть
Когда данные собраны, на руках у автора обычно черновик. Заметки, скриншоты, цифры, переписка с поддержкой и несколько мыслей, которые пока живут скорее в голове, чем на бумаге. Превратить всё это в понятный и читаемый текст — отдельная работа. Вот её сегодня и берёт на себя нейросеть.
По сути, она работает редактором. Выстраивает структуру, помогает превратить сырую мысль в понятную, подсказывает, где читатель потеряет нить, и аккуратно упаковывает текст. Раньше на это уходили часы автора или время отдельного человека. Теперь эти часы можно потратить на то, что тексту действительно нужно: ещё раз перепроверить данные, ещё раз написать в поддержку.
И это ровно та же оптимизация, о которой мы говорим в любой другой работе. Раньше текст ходил по кругу: автор отдал редактору, получил правки, переписал, снова отдал. И так несколько раз. Каждый круг — это ожидание и пересылки. Сейчас вся цепочка закрывается в одно окно: автор работает с редактором напрямую и сразу видит результат. Итераций меньше, а решения всё так же принимает автор.
Но тут есть важный момент. Сама по себе нейросеть пишет обезличенно: ровно, гладко и одинаково для всех. Чтобы текст звучал как ваш, её нужно этому научить. Показать свои тексты, объяснить, как вы формулируете мысли, и поправлять каждый раз, когда она сбивается на общий тон. Это тоже работа автора. И если её пропустить, получится ещё одна статья, похожая на тысячи других.
Так вот, здесь и возникает асимметрия. Редакторы были всегда. Через них проходят статьи в журналах, книги, отчёты. И никому не приходит в голову сказать, что исследование написал редактор, потому что он переставил абзацы. Но стоит редактором стать нейросети, и заслуга автора вдруг оказывается под вопросом. Хотя роли не поменялись: один принёс содержание, другой помог его изложить.
Что можно понять по тире, а что нет
У нейросетей действительно есть узнаваемые привычки. Они любят длинные тире, аккуратно ставят «ё», раскладывают всё по полочкам. Но длинное тире и «ё» — это просто нормы русской типографики. Их ставят внимательные авторы, корректоры, автозамена в Word и онлайн-типографы, которые появились задолго до нейросетей. Получается, аккуратное оформление теперь легко принять за признак нейросети.
Почему люди смотрят на эти признаки, понять можно. Слабых сгенерированных текстов сейчас правда много, и внешние признаки помогают быстро их отсеять, не тратя время на чтение. Но у такого фильтра есть недостаток: он видит оформление, а содержание остаётся за кадром.
По форме можно угадать, чем текст оформляли. Но есть ли за ним работа, по форме не узнать. Пустой текст без единого тире всё равно останется пустым. А текст с реальными данными не станет хуже из-за аккуратно расставленных запятых. Если оценивать тексты только так, авторам придётся специально оставлять опечатки, чтобы текст не приняли за сгенерированный. Странная выходит логика.
При этом было бы нечестно сказать, что у критики нет никаких оснований. Есть. Нейросеть действительно тянет текст к шаблону: обтекаемые зачины, общие фразы, красивые выводы, которые ничем не подкреплены. Может додумать пример, которого не было, или выдать уверенное утверждение, которое никто не проверял. Следить за этим — задача автора. Вычитывать редактуру, убирать всё, что нельзя доказать, возвращать тексту свои формулировки. Ровно так же, как раньше автор проверял правки живого редактора.
А если статью можно было целиком получить одним запросом к нейросети, значит, автор не вложил в неё ни данных, ни опыта. И дело тут совсем не в инструменте.
По чему тогда оценивать текст
Мне кажется, есть проверка надёжнее, чем поиск тире. Достаточно задать себе несколько вопросов. Есть ли в тексте то, чего нет в открытом доступе: свои данные, скриншоты, ответы первоисточника? Есть ли в нём опыт: что пробовали, что сработало, что нет? Признаётся ли автор, чего он не знает или не может доказать? И можно ли проверить то, что написано?
Если на большинство вопросов ответ «да», работа проделана. И уже не так важно, кто расставлял запятые. А текст без всего этого останется слабым, даже если автор написал каждое слово сам.
Поэтому мой вывод простой. Качество статьи определяет то, что в неё вложил автор. Если он снял данные, проверил гипотезу и покопался в первоисточниках, ИИ поможет быстрее превратить это в понятный текст. Если нет, хорошей статьи не получится даже с самой сильной моделью.
Так что оценивать текст стоит по содержанию. А тире пусть остаётся тире.
Комментарии
Написать комментарийВойти