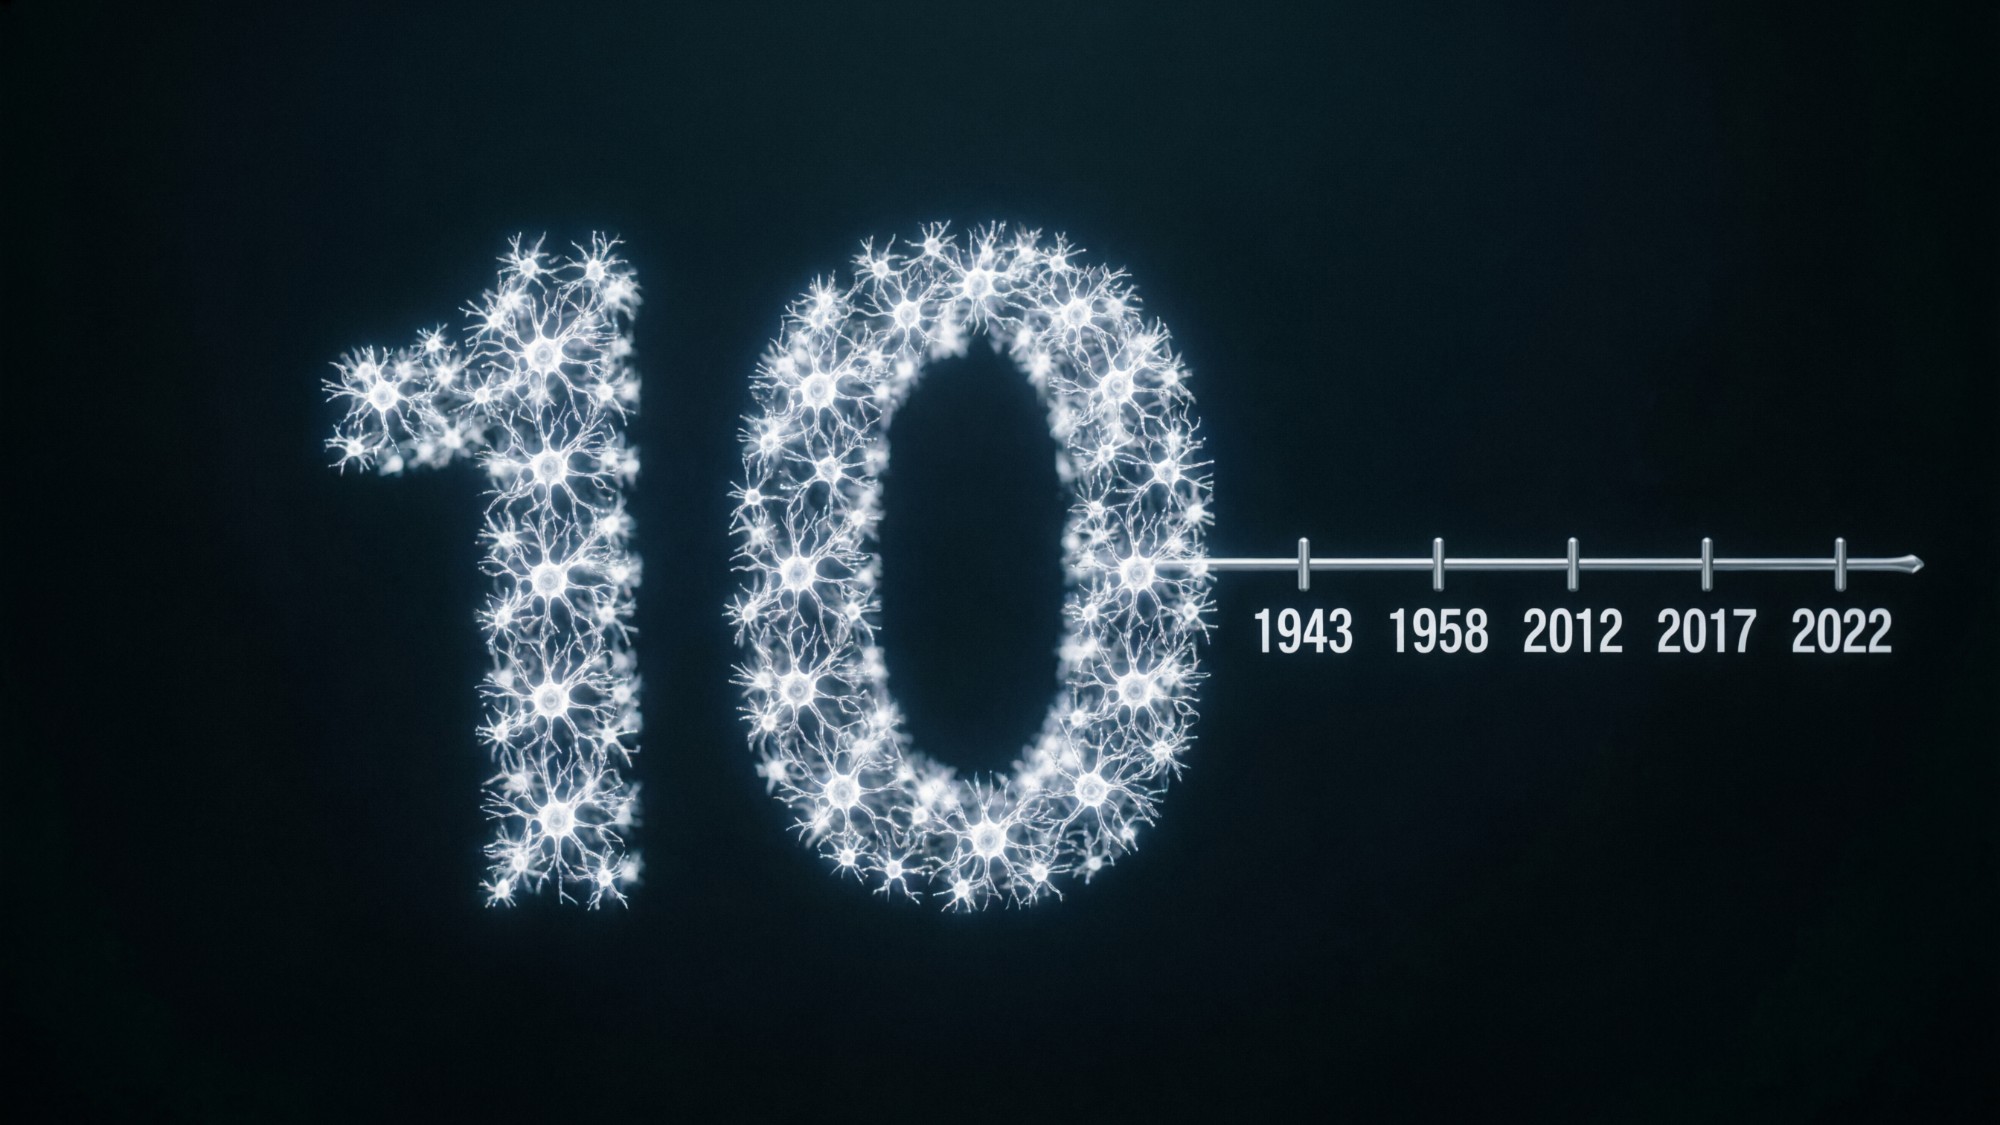
10 интересных фактов о нейросетях, о которых редко вспоминают
Нейросети обсуждают все: одни обещают, что они заменят половину профессий, другие — что это мыльный пузырь. Но за обоими лагерями легко потерять главное: у технологии длинная и довольно драматичная история. Ей больше восьмидесяти лет, она пережила две волны разочарования и несколько раз почти исчезала из повестки.
Вот десять фактов, которые объясняют, откуда взялись современные модели — и почему они ведут себя именно так, а не иначе.
1. Нейросеть придумали в 1943 году — до первого компьютера
Первую математическую модель искусственного нейрона описали Уоррен Маккаллок и Уолтер Питтс в работе «Логическое исчисление идей, относящихся к нервной деятельности». Они предложили простую идею: нервную клетку можно описать как устройство, которое складывает входные сигналы и срабатывает, если сумма превышает порог.
Никакого обучения тогда не было — веса задавались вручную. Но сама логика «нейрон как вычислительный элемент» появилась ещё до того, как появились машины, способные её толком посчитать.
Почему это интересно: нейросети — не побочный продукт больших данных и видеокарт. Это очень старая идея, которой просто долго не хватало вычислительной мощности.
2. Первый перцептрон обещал, что машина научится ходить и говорить
В 1958 году Фрэнк Розенблатт построил перцептрон — первую модель, которая обучалась на примерах и подстраивала веса сама. Это был не софт, а реальная машина: ячейки памяти, моторы, провода.
Американская пресса писала, что перцептрон научится распознавать лица, читать вслух и, возможно, «осознавать себя». Военные финансировали работу охотно: заказчик видел в этом автоматический разведчик, который сам отличает танк от дерева.
Ожидания не оправдались. Перцептрон решал только линейно разделимые задачи, и этого хватало не для всего.
3. «Зимы» ИИ были дважды — и оба раза из-за завышенных обещаний
Первая волна разочарования пришлась на 1974–1980 годы: отчёты показали, что системы не масштабируются, а финансирование резко сократили. Само слово «искусственный интеллект» на какое-то время стало неудобным — его избегали в заявках на гранты.
Вторая волна случилась в конце 1980-х — начале 1990-х, когда рухнул рынок «экспертных систем»: дорогие в поддержке, они плохо переносили исключения из правил. Многие компании свернули направление, а исследователи переименовывали лаборатории в «машинное обучение» и «когнитивные системы», чтобы не попасть под ярлык.
Мораль: нынешний хайп — третий по счёту. Это не значит, что он обязательно закончится так же, но историческая рифма очевидна.
4. «Обучение» — это буквально подбор чисел, а не закладка правил
Когда модель «учится», внутри не происходит ничего похожего на объяснение правил. Есть миллионы или миллиарды весов — чисел, которые задают силу связей между нейронами. На каждом примере модель выдаёт ответ, сравнивает его с правильным и чуть-чуть сдвигает веса, чтобы в следующий раз ошибиться меньше.
Процедура, которая это делает, называется обратным распространением ошибки. Её широко популяризировали в 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс, хотя похожие идеи высказывались и раньше, в том числе Полом Вербосом в 1974-м.
Следствие: в модели нет базы знаний, которую можно открыть и проверить. Знание распределено по весам, и это одна из причин, почему поведение сети так трудно объяснить.
5. Перелом случился в 2012 году на конкурсе распознавания картинок
До 2012 года классические алгоритмы компьютерного зрения ошибались на ImageNet примерно в четверти случаев. На конкурсе ILSVRC-2012 нейросеть AlexNet показала top-5 ошибку 15,3% — при том что у второго места было 26,2%.
Разница в 10,9 процентного пункта была не улучшением, а сменой эпохи. У AlexNet было около 60 миллионов параметров, и обучали её на двух потребительских видеокартах GTX 580 несколько дней — именно GPU сделали такой эксперимент возможным.
После этого нейросети перестали быть академической экзотикой: в течение пары лет их начали применять в распознавании речи, переводе и рекомендациях.
6. Всё, что мы называем «ИИ» сегодня, выросло из одной статьи 2017 года
В работе «Attention Is All You Need» исследователи Google предложили архитектуру трансформера. Главная идея — механизм внимания: модель учится взвешивать, какие части входного текста важны для каждого следующего слова, и может делать это параллельно, а не последовательно, как рекуррентные сети.
Именно на трансформерах построены GPT, Claude, Gemini, GigaChat и большинство современных языковых моделей. Статья занимает около десяти страниц, а её авторы — восемь человек.
Что это значит: архитектурная революция случилась не в 2022 году, когда вышел ChatGPT, а пятью годами раньше — просто широкой публике понадобилось время, чтобы это заметить.
Простыми словами о трансформере и механизме attention - в статье
7. «Больше параметров» — не всегда лучше: есть оптимальный масштаб
В 2020 году GPT-3 показала 175 миллиардов параметров, и это стало символом гонки масштабов. Но в 2022-м работа Chinchilla показала важную вещь: при фиксированном бюджете вычислений модель стоит обучать примерно на 20 токенах на каждый параметр. Тогда GPT-3, по этим меркам, оказалась недообученной: у неё было слишком много параметров для того объёма текста, который она видела.
Вывод простой и неудобный: качество зависит не от одной цифры в названии модели, а от баланса между размером, данными и вычислениями. Именно поэтому небольшие, но хорошо обученные модели нередко обходят гигантов на конкретных задачах.
8. Галлюцинации — не баг, а прямое следствие устройства модели
Языковая модель предсказывает следующее слово. Она не проверяет факты по базе и не «знает» их в человеческом смысле — она строит наиболее вероятное продолжение текста. Если в обучающих данных пробел или вопрос сформулирован необычно, модель всё равно выдаст правдоподобно звучащий ответ.
Именно поэтому она уверенно придумывает несуществующие статьи, даты и цитаты. Дообучение на человеческих предпочтениях (RLHF) снижает частоту таких ошибок, но не устраняет причину: уверенный тон — это свойство хорошей языковой модели, а не признак правоты.
Практический вывод: любые факты, цифры и ссылки из ответа модели нужно проверять отдельно. Это не недоверие к технологии, а понимание того, как она устроена.
9. Обучение и работа моделей стоят огромных денег и энергии
Обучение крупной модели — это не «запустить скрипт на ноутбуке». Речь о тысячах видеокарт, которые неделями работают в дата-центрах, потребляя мегаватт-часы электроэнергии. Точные цифры сильно различаются в зависимости от методики подсчёта, но порядок именно такой.
Дальше начинается не менее дорогая часть — inference, то есть ответы на запросы пользователей. Каждый запрос к большой модели требует вычислений, и при миллионах пользователей это превращается в постоянную нагрузку на инфраструктуру.
Настолько серьёзную, что в 2024 году Google и Microsoft начали договариваться о покупке энергии у атомных станций — не из любви к физике, а потому что иначе растущее энергопотребление дата-центров просто не закрыть.
10. Нейросети уже сделали настоящую научную революцию — только не в чатах
В 2020 году AlphaFold от DeepMind предсказала структуру белков на уровне, который эксперты CASP14 назвали решённой проблемой. В 2021-м вышла статья в Nature, а в 2022-м база AlphaFold Protein Structure Database выросла до более чем 200 миллионов предсказанных структур — почти все известные науке белки.
Это не «чат-бот, который хорошо пишет текст», а инструмент, который экономит годы лабораторной работы: структура белка определяет его функцию, а значит — понимание болезней и поиск лекарств.
Главный факт из этого пункта: самый заметный вклад ИИ в науку пока происходит не там, где о нём больше всего говорят.
Что из этого следует
Нейросети — не магия и не разум. Это математическая конструкция, которая очень хорошо находит закономерности в данных, если ей дать достаточно примеров и вычислений. Она ошибается уверенно, стоит дорого и лучше всего работает там, где есть чёткая проверка результата.
Понимание этих десяти фактов не делает вас специалистом по ИИ, но помогает задавать правильные вопросы: какие данные использовались, как проверялся результат, сколько это стоит и что именно модель оптимизирует.
А история технологии подсказывает ещё одну вещь: нынешний этап — не финал, а очередная глава. Предыдущие две заканчивались разочарованием не потому, что идея была плохой, а потому что реальность оказывалась сложнее обещаний.
Еще интересное:
Как работает трансформер: от токенов до предсказания следующего слова
Комментарии
Написать комментарийВойти