Как работает трансформер: от токенов до предсказания следующего слова
Трансформер — архитектура, на которой построены почти все современные языковые модели. Звучит сложно, но базовая механика укладывается в одну фразу: модель разбивает текст на кусочки, смотрит на контекст через внимание и предсказывает следующий токен. И так — по шагу.
Ниже — разбор этой механики на примерах, без формул.
Коротко: что делает трансформер
Трансформер — это нейросеть, которая получает текст, разбивает его на токены (кусочки слов и символов) и на каждом шаге предсказывает следующий токен.
Пример:
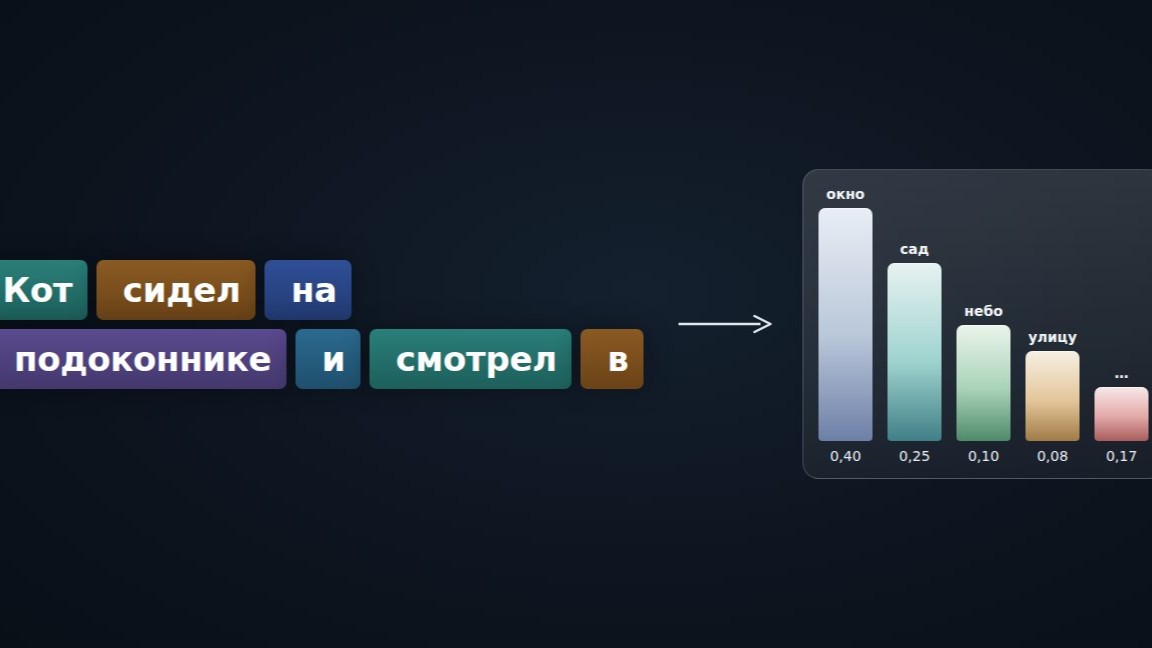
«Кот сидел на подоконнике и смотрел в …»
Модель смотрит на все предыдущие слова и выдаёт вероятности:
«окно» — 40%
«сад» — 25%
«небо» — 10%
«улицу» — 8%
и так далее.
Потом выбирает один токен, добавляет его к тексту и повторяет: получилось «окно» — дальше предсказывает следующее слово уже с учётом «окно».
Так и генерируется текст: по одному токену за шаг.
1. Токены и эмбеддинги
Модель не видит буквы как человек. Текст сначала режется на токены.
Примерно так:
«Кот сидел на подоконнике» → [«Кот», « сидел», « на», « подокон», «нике»]
Каждый токен превращается в вектор чисел — эмбеддинг. Это как «координаты смысла» в многомерном пространстве. У близких по смыслу слов векторы часто похожи.
Но одного эмбеддинга мало: слово «банк» в «банк реки» (в значении «берег») и «банк выдал кредит» означает разное. Поэтому дальше работают слои внимания.
2. Главная идея: внимание
Attention — это механизм, который даёт каждому слову «посмотреть» на другие слова и понять контекст.
Простая аналогия:
каждое слово задаёт вопрос («кто?», «где?», «что делает?»);
сравнивает себя с другими словами;
собирает информацию от самых релевантных слов.
Пример:
«Собака не укусила мужчину, потому что она была слишком добрая.»
Кто такая «она»? Модель через внимание связывает «она» с «собака», а не с «мужчину». Для этого она смотрит на контекст.
Внутри это обычно описывают через Q, K, V:
Query — «что я ищу?»
Key — «что во мне есть?»
Value — «какую информацию я могу отдать?»
Слово «она» формирует запрос: «я ищу существительное женского рода, которое может быть добрым». Слово «собака» даёт ключ, который хорошо совпадает. Поэтому «она» получает много информации от «собака».
Мини-пример весов внимания
Для слова «она» в предложении выше веса могут быть примерно такими:
«собака» — 0,62
«добрая» — 0,15
«укусила» — 0,08
«мужчину» — 0,05
остальные — 0,10
Модель не «понимает» это по-человечески, но численно так смешивает информацию.
3. Multi-head attention: несколько взглядов сразу
Одно внимание может смотреть на одно отношение, другое — на другое.
Пример с предложением:
«Вчера я купил красную машину, потому что она была дешёвой.»
Разные «головы» внимания могут отслеживать:
кто что купил;
что «она» относится к «машина»;
что «красная» описывает «машину»;
что «вчера» задаёт время.
Это как несколько читателей смотрят на текст под разными углами, а потом их выводы объединяются.
4. Позиция слов тоже важна
Трансформер сам по себе не знает порядок слов, поэтому в классической архитектуре к эмбеддингам добавляют позиционную информацию.
Пример, где порядок меняет смысл:
«Собака укусила человека.»
«Человек укусил собаку.»
Слова почти те же, но смысл разный. Позиционное кодирование помогает модели различать порядок.
5. Слои трансформера
Один слой трансформера примерно делает так:
Смотрит на контекст через внимание.
Добавляет найденную информацию к исходному представлению.
Прогоняет через небольшую нейросеть (FFN), которая «перерабатывает» признаки.
Нормализует и передаёт дальше.
Таких слоёв много — десятки. Чем выше слой, тем более абстрактные вещи улавливаются:
нижние слои — формы слов, простые связи;
средние — синтаксис, локальный смысл;
верхние — тема, логика, намерение, стиль.
6. Как модель учится
Обучение языковой модели — это в основном предсказание следующего токена на огромном тексте.
Пример обучающего фрагмента:
«Летом мы поехали на дачу и жарили …»
Правильный ответ: «шашлыки» или «мясо». Модель выдаёт вероятности, сравнивает с правильным токеном и немного подкручивает веса, чтобы в следующий раз дать правильному токену вероятность выше.
Так миллионы раз на миллиардах фрагментов. Постепенно модель выучивает грамматику, факты, стили, шаблоны рассуждений — не как база данных, а как статистические связи.
7. Генерация текста по шагам
Пусть промпт:
«Напиши начало сказки: В маленьком лесу жил …»
Шаг 1. Модель смотрит на промпт и предсказывает вероятности:
«ёжик» — 30%
«заяц» — 20%
«волшебник» — 10%
Выбрала «ёжик».
Шаг 2. Теперь контекст: «…жил ёжик». Предсказывает дальше:
«,» — 35%
« который» — 25%
« и» — 10%
Выбрала «, который».
Шаг 3. Контекст: «…жил ёжик, который». Дальше: «очень», «любил», «каждое»…
И так до конца.
8. Почему иногда модель «фантазирует»
Потому что она не проверяет факты в интернете на каждом шаге. Она предсказывает правдоподобное продолжение на основе выученных закономерностей.
Пример:
«Столица Австралии — …»
Если модель хорошо выучила, ответит «Канберра». Если нет — может сказать «Сидней», потому что Сидней часто встречается рядом с Австралией. Это не злой умысел, а следствие вероятностного предсказания.
9. Температура и выбор токена
Модель выдаёт вероятности. Как выбрать слово?
Жадный выбор: всегда самый вероятный токен. Текст стабильный, но может быть скучным.
С температурой: иногда выбираем менее вероятные токены. Выше температура — более креативно и рискованно.
Top-p / top-k: выбираем только из самых вероятных вариантов.
Пример для продолжения «Я люблю …»: при низкой температуре — «кофе»; при высокой — «кофе», «дождь», «старые фильмы», «странные идеи».
10. Главная формула простыми словами
Трансформер как языковая модель делает примерно так:
текст → токены → векторы → много слоёв внимания и переработки → вероятности следующего токена → выбрать токен → добавить к тексту → повторить.
И всё это — ради одного действия: предсказать, что вероятнее всего идёт дальше.
Пример целиком
Промпт:
«Мальчик открыл дверь и увидел …»
Модель:
Разбивает на токены.
Превращает в векторы.
Через внимание связывает «открыл» с «дверь», «увидел» с «мальчик».
Понимает контекст: это повествование, скорее всего, дальше будет объект или сцена.
Выдаёт вероятности: «комнату» — 18%, «собаку» — 12%, «что-то» — 9%, «лес» — 7%.
Выбирает «комнату».
Добавляет: «Мальчик открыл дверь и увидел комнату».
Продолжает.
Вот и вся базовая механика: контекст через внимание + предсказание следующего токена + повторение.
Комментарии
Написать комментарийВойти