Атака на Beget: чему учит единая точка отказа в инфраструктуре
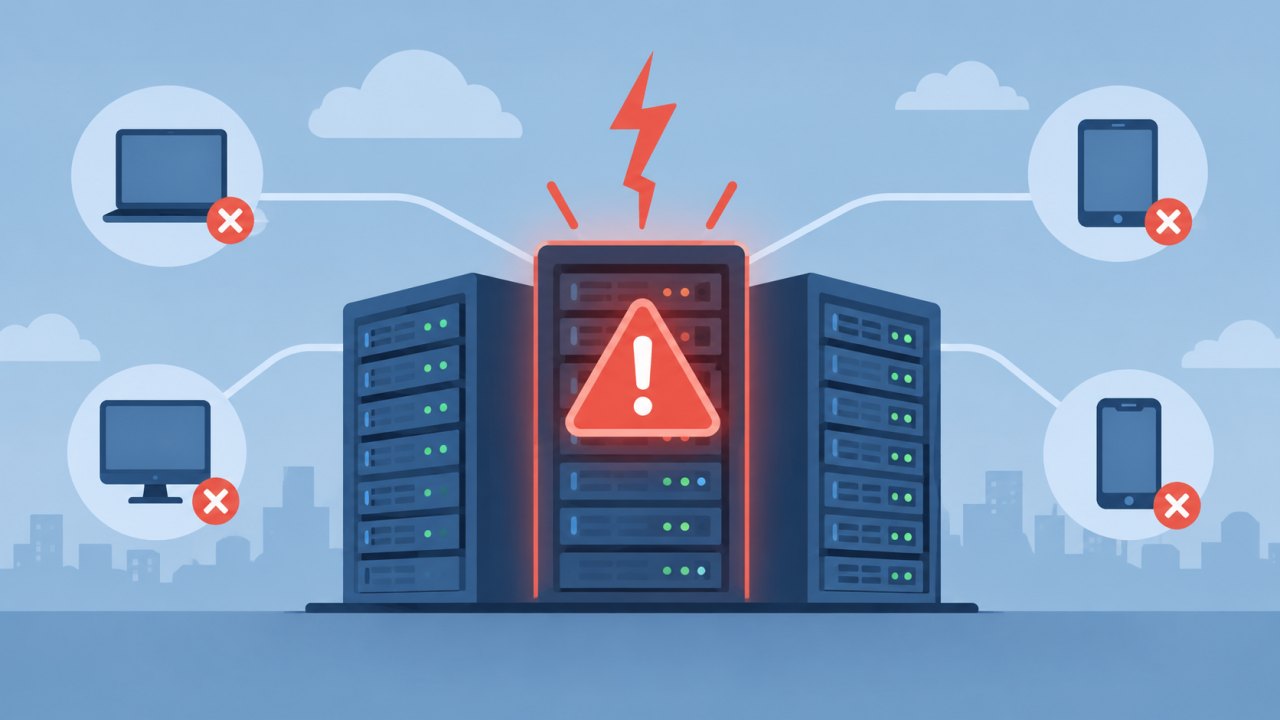
Главный урок истории с Beget сейчас не в том, «как плохо сработали админы». На 4 ноября 2026 года картина выглядит иначе: провайдер постепенно восстанавливает инфраструктуру после целевой атаки на управляющий контур, а клиенты одновременно обнаружили неприятную вещь — если домен, DNS, серверы и резервные копии завязаны на одного поставщика, отказ одной точки может парализовать весь бизнес.
Я пользуюсь Beget с 2017 года и оказался не сторонним наблюдателем: у меня и у организаций, которые я обслуживаю, легли почта, сайты, виртуальные машины, Gitea и Mattermost. Поэтому сейчас важнее не искать виноватых в комментариях, а разобраться, что именно произошло и какой вывод из этого может сделать любой владелец сайта или ИТ-инфраструктуры.
Что случилось
Beget — один из крупнейших игроков российского хостинга и регистрации доменов. По приведённым в исходных материалах оценкам, осенью 2026 года на компанию приходилось около 13–15% рынка доменов в зонах .RU и .РФ, она обслуживала более 200 тысяч клиентов, а на её инфраструктуре размещалось до 500 тысяч активных сайтов.
Это важно не ради красивых цифр. По масштабу Beget — цифровой многоквартирный дом: в одной инфраструктуре соседствуют личные проекты, интернет-магазины и сервисы, которыми пользуются крупные компании. Поэтому сбой затронул не только отдельных вебмастеров: проблемы, по исходным данным, возникли в том числе у BelkaCar и сайта системы маркировки «Честный знак».
По официальной информации Beget, злоумышленники получили доступ к системе управления всей инфраструктурой и запустили скрипты, предназначенные для обнуления данных. Когда атака проходит через управляющий контур, проблема уже не сводится к «перезапуску сервера». Нужно убедиться, что каждый восстановленный узел не содержит вредоносного ПО или скрытой точки повторного заражения.
Отсюда и ручная работа: инженерам приходится проверять и возвращать в строй серверы, диски и сетевые компоненты поэтапно. Слишком быстрое включение непроверенного оборудования может просто запустить атаку заново.
Что успели восстановить
Хронология из официальных сообщений Beget показывает, что восстановление идёт по частям:
- 2 ноября, 14:00 — восстановлены выделенные серверы без администрирования со стороны Beget.
- 2 ноября, 17:00 — восстановлена работа NS-серверов для всех доменов.
- 3 ноября, 12:00 — восстановлено более 80% инфраструктуры почты: POP3, IMAP и SMTP.
- 3 ноября, 15:00 — запущен отдельный сервис управления доменами.
- 4 ноября, 01:00 — появились первые сайты на восстановленных серверах виртуального хостинга.
Это не означает, что сервис полностью вернулся в норму. Но такая последовательность хорошо показывает, почему «просто включить всё обратно» невозможно: сначала нужно вернуть базовые управляющие и сетевые компоненты, затем безопасно поднимать сами нагрузки.
Что потеряно, а что сохранилось
Здесь особенно важно не смешивать разные типы данных.
По официальным заявлениям Beget и пересказам профильных СМИ:
- Облачная инфраструктура — VPS, S3 и Kubernetes: данные утрачены.
- Бинарные резервные копии VPS: полностью уничтожены. Они позволяли восстанавливать виртуальные машины целиком.
- Файловые резервные копии: сохранились. Для виртуального хостинга и облачной инфраструктуры это оставляет возможность вернуть файлы и данные, но доступ к ним пока не предоставляется до завершения восстановления и проверки инфраструктуры.
- Настройки CDN и IP-адресов: утрачены.
- Виртуальный хостинг: по предварительной оценке Beget, подлежит восстановлению почти 100% размещённых там сайтов.
Поэтому ситуация для разных клиентов выглядит по-разному. Потеря бинарного бэкапа VPS и возможность восстановить файлы из файловой копии — это принципиально разные сценарии.
Почему «у вас же есть бэкап» не всегда спасает
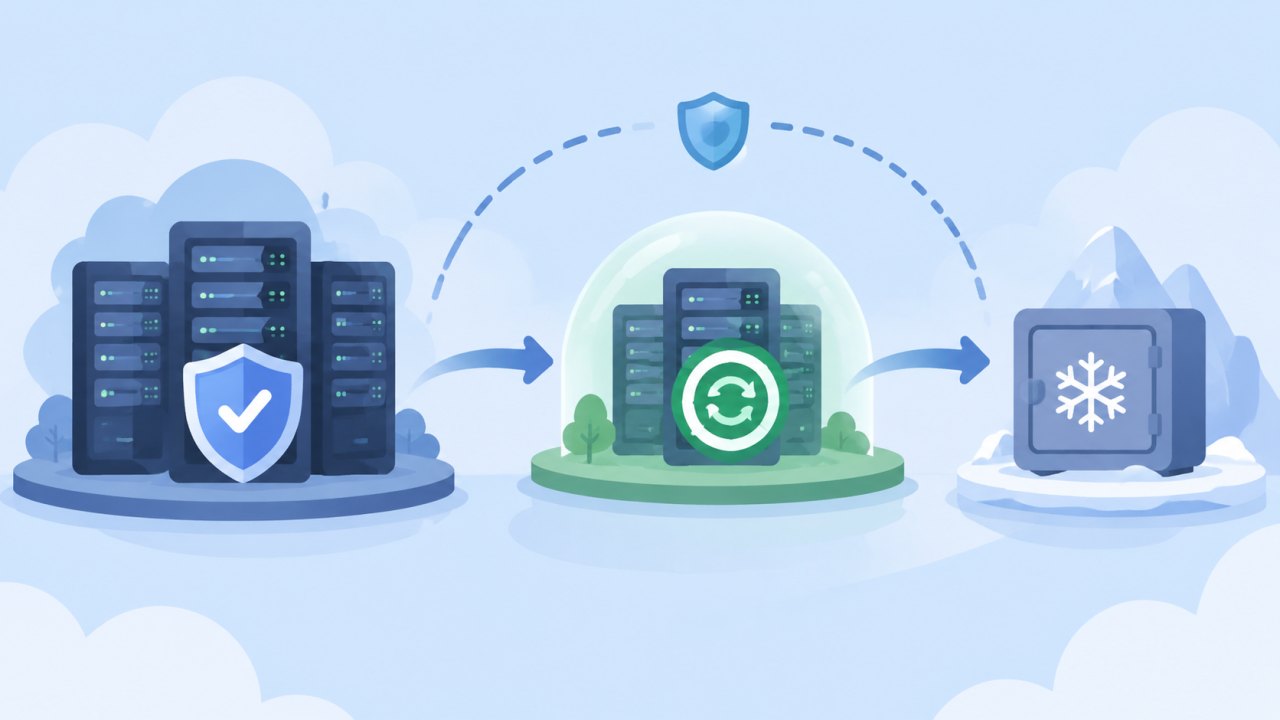
Обычно резервную копию воспринимают как кнопку «откатить всё назад». Но резервная копия полезна только в связке с независимой точкой восстановления.
Если бэкап хранится внутри той же инфраструктуры и управляющего контура, что и рабочие данные, успешная атака на этот контур способна уничтожить оба слоя сразу. Именно это и стало главным техническим уроком истории с Beget.
Надёжнее выглядит архитектура, где:
- регистратор домена находится отдельно;
- DNS управляется независимо;
- рабочие серверы не являются единственным местом хранения данных;
- резервные копии лежат в другом облаке или на другом физическом контуре;
- критически важные копии не имеют постоянного сетевого доступа к основной инфраструктуре.
Тогда даже при падении одного провайдера у владельца бизнеса остаётся хотя бы возможность переписать DNS, поднять резервную площадку и вернуть трафик.
И здесь ответственность уже не только на хостере. Клиент сам выбирает, насколько сильно связывать между собой домен, DNS, серверы, бэкапы и средства управления.
Почему сейчас рано объявлять Beget «некомпетентным»
После крупной аварии соцсети почти всегда превращаются в суд: появляются версии про «кривые руки», плохих админов и плохую архитектуру. Проблема в том, что без внутреннего расследования доказать такую версию невозможно.
Мы пока не знаем точного вектора атаки и набора использованных уязвимостей. А отзывы вроде «поддержка долго отвечает» или «деньги списались» вообще не позволяют судить о способности компании противостоять целевой атаке на управляющую инфраструктуру.
По исходным данным, Beget исторически делал ставку на собственную панель управления и сильную инженерную команду. Но даже хорошая эксплуатация не даёт иммунитета от серьёзного инцидента. На этом этапе корректнее дождаться технического разбора и уже по нему обсуждать, какие меры защиты были достаточными, а какие — нет.
Главное сейчас проще: не мешать аварийному восстановлению искать виноватых раньше времени.
Юридический вопрос пока тоже не имеет простого ответа
Beget официально заявил о возникновении обстоятельств непреодолимой силы со ссылкой на п. 3 ст. 401 ГК РФ. И здесь начинается уже не технический, а юридический спор.
Для кибератак нет универсального правила «хакеры = форс-мажор». Суду важно оценивать конкретные обстоятельства: насколько событие было чрезвычайным и непредотвратимым, какие меры защиты принимались заранее, можно ли было предотвратить последствия.
В подборке источников к исходному материалу приведены судебные кейсы и обзоры, согласно которым кибератаки далеко не всегда освобождают компанию от ответственности. Одновременно отдельно отмечается возможность иной оценки, если будет доказан действительно беспрецедентный масштаб атаки или использование уязвимости нулевого дня.
Поэтому заявления о том, что Beget «точно ничего не должен клиентам» или, наоборот, «точно обязан компенсировать всё», сейчас преждевременны.
Самая неприятная часть: всё было завязано на одну точку
Если смотреть на инцидент не глазами аварийной команды, а глазами архитектора, проблема становится ещё интереснее.
Массовый хостинг продаёт прежде всего удобство: домен в одном месте, NS-серверы там же, VPS рядом, бэкап — ещё одним переключателем в панели. Для обычного пользователя это логично. Для отказоустойчивости — не всегда.
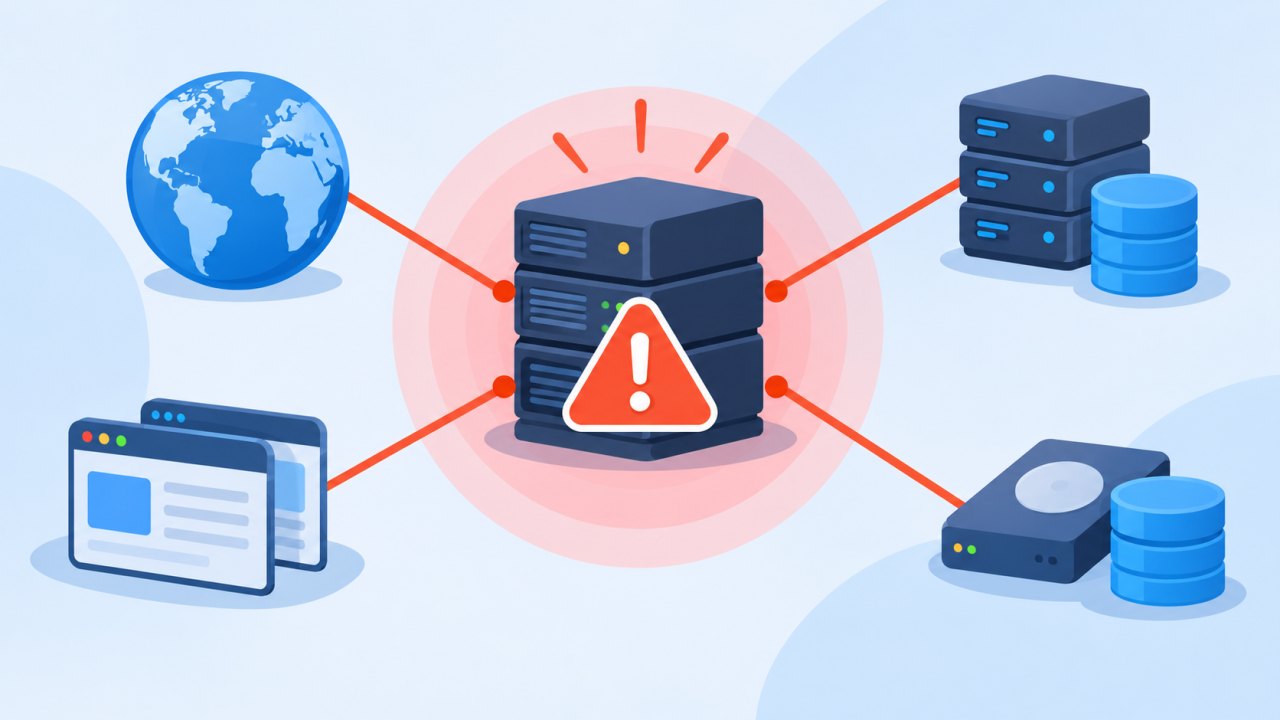
В случае с Beget последствия оказались особенно болезненными именно из-за централизации. Когда управляющий контур недоступен, клиент может потерять не только сервер, но и возможность быстро воспользоваться собственными инструментами управления: поменять DNS, переключить трафик, поднять резервную машину или получить доступ к привычной панели.
Получается парадокс: чем удобнее вся инфраструктура собрана в одном месте, тем больше эффект единой точки отказа.
Это не аргумент против Beget как такового. Это аргумент против архитектуры, в которой один поставщик становится одновременно регистратором, DNS-провайдером, хостингом, облаком и системой резервного копирования.
Дешёвый хостинг здесь не главный виновник
Beget долго выигрывал за счёт доступных тарифов и недорогих VPS. Это помогло компании собрать огромную клиентскую базу, а вместе с ней — огромную концентрацию риска.
Но делать из этого вывод «дешёвое = небезопасное» было бы слишком просто.
Крупные и дорогие инфраструктуры тоже ломаются. В исходном материале приводятся, например, случаи со сбоем Yandex Cloud после атаки на дата-центр, утечками данных и инцидентом с сетью Ростелекома. Эти примеры показывают главное: бюджет сам по себе не создаёт неуязвимость.
У безопасности есть цена — аудит, сегментация, резервирование, мониторинг, специалисты, изолированные контуры. Но и крупная инфраструктура остаётся сложной системой с человеческим фактором, физическими рисками и потенциальными уязвимостями.
Поэтому точнее говорить не «дешёвый хостинг плох», а «централизация увеличивает цену одной ошибки». Чем больше сервисов и клиентов завязано на одну управляющую точку, тем масштабнее последствия её компрометации.
Что делать владельцу сайта уже сейчас
Из этой истории полезно вынести не только сочувствие к инженерам, но и вполне практический чек-лист.
- Проверьте, где физически лежат резервные копии и кто имеет к ним доступ.
- Убедитесь, что критические бэкапы не удаляются тем же управляющим контуром, который отвечает за рабочую инфраструктуру.
- Держите домен и DNS там, откуда можно управлять ими даже при полном падении основного хостинга.
- Проверьте, сможете ли вы за несколько часов поднять критичный сервис у другого провайдера.
- Для важных систем отдельно храните конфигурации, ключи, секреты, IP-адреса и инструкции по восстановлению.
- Проведите простой мысленный тест: «Что будет, если сегодня мой хостер исчезнет на 48 часов?»
Если на последний вопрос ответом становится «мы ничего не можем сделать без личного кабинета хостера», архитектуру уже стоит пересматривать.
Что с этим делать дальше
История Beget ещё не закончена. Техническое восстановление продолжается, а окончательные выводы о причинах атаки, степени ответственности и компенсациях можно делать только после официального разбора.
Для самой компании это сейчас марафон по восстановлению доверия. Для клиентов — повод перестать считать SLA и автоматические бэкапы синонимами настоящей отказоустойчивости.
99,9% аптайма не помогут, если одновременно недоступны домен, DNS, серверы, панель управления и резервные копии.
Главный вывод здесь довольно простой: резервная инфраструктура должна быть независимой от основной не только физически, но и организационно. Один провайдер может быть удобным, быстрым и надёжным годами. Но если от него зависит вообще всё, одна большая авария превращает удобство в единую точку отказа.
А пока Beget продолжает поднимать сервисы, разумнее всего использовать эту паузу для собственного аудита: проверить независимые бэкапы, доступ к DNS и план аварийного переключения. Даже если ваш провайдер никогда не столкнётся с атакой такого масштаба, именно такой сценарий лучше всего показывает реальную устойчивость архитектуры.
Комментарии
Написать комментарийВойти