Ответы Алисы AI появляются в 44% запросов, генерация карточек товаров LLM: 7 SEO-событий недели
За неделю в поиске произошло сразу несколько событий, которые влияют не только на SEO-специалистов, но и на владельцев сайтов: Яндекс продолжает восстанавливать Вебмастер после аварий в ЦОД, проблемы с прокси и кодами 429 искажали съёмку позиций, а Google, Bing, OpenAI и Anthropic договорились о едином подходе к управлению ИИ-обучением через robots.txt.
Плюс — два практических кейса. В одном SEO-специалист строит структуру сайта под query fan-out ИИ-поиска, в другом команда на 10 200 карточках запчастей показывает, как без контроля LLM начинает выдумывать характеристики товаров.
Ниже — семь главных событий недели, цифры, условия и проверки, которые можно забрать в работу.
1. Яндекс возвращает Вебмастер — и показывает масштаб ответов Алисы
29 октября Яндекс сообщил сразу о двух важных вещах: какие функции Вебмастера вернулись после октябрьских аварий и насколько широко в поиске уже используются ответы Алисы AI.
Внешнее API Вебмастера снова работает для тех разделов, которые уже доступны в веб-интерфейсе. Также восстановлены:
- «Безопасность и нарушения»;
- настройка скорости переобхода;
- привязка счётчика Метрики;
- «Баллы за отзывы».
При этом две заметные проблемы к 1 ноября всё ещё сохранялись. Инструмент «Переезд сайта» оставался в режиме «Только для чтения», а вебмастера жаловались на проблемы с индексацией новых проектов и обновлений, начавшиеся 6 октября.
Отдельный показатель — масштаб нейросетевой выдачи. В неаудированном отчёте Яндекса за III квартал 2026 года говорится, что ответы Алисы AI появляются уже в 44% запросов Поиска. Ежемесячная аудитория таких ответов выросла на 11% и достигла 54,8 млн человек. В чате с Алисой AI каждую неделю общаются 45 млн пользователей — на 36% больше, чем кварталом ранее.
Что проверить на этой неделе:
- откройте «Безопасность и нарушения» во всех рабочих проектах;
- перезапустите скрипты, которые используют внешнее API Вебмастера;
- проверьте, что открытые эндпоинты API снова отвечают кодом 200;
- плановые переезды и склейки зеркал лучше отложить, пока «Переезд сайта» не вернётся из режима чтения.
Источник: Блог Яндекса для вебмастеров, SEOnews.
2. Почему съёмщики позиций теряли сайты из топ-10: 76% ошибок 429
Во второй половине октября многие парсеры начали показывать прочерки по сайтам, которые при ручной проверке оставались в первой десятке Яндекса.
Причину 29 октября разобрал Андрей Калашников в исследовании почти 2,7 млн поисковых сессий. В выборку вошли 2 699 979 сессий по 17 пулам прокси за 16–23 октября.
После аварий в трёх дата-центрах Яндекса — в Сасове, Калуге и Владимире — при плотном потоке запросов балансировщики стали чаще отдавать HTTP 429. На наиболее нагруженных стационарных пулах доля отказов доходила до 76,14%.
Проблема была не только в ограничениях. Из-за рассинхрона поисковых шардов и урезанной выдачи из резервного кэша сайты из топ-10 иногда получали от парсера ложный статус «Не найдено». В период 16–23 октября доля таких потерь доходила до 6,02% на нагруженных мобильных пулах и до 2,99% у российских мобильных операторов.
К 23 октября ситуация на мобильных пулах заметно стабилизировалась: на шести мобильных пачках с ротацией доля «Не найдено» опустилась до 0% при 63–68% успешных сессий. На стационарных подсетях 429 по-прежнему оставался на уровне 71–76%, а ложный статус «Не найдено» — в диапазоне 3,20–5,02%.
Важно и ограничение самого кейса: автор отмечает, что при щадящем парсинге, паузах и смене IP раз в 15 минут обычные резидентские прокси работают нормально.
Поэтому резкий «вылет» страниц из отчёта во второй половине октября ещё не означает падение позиций.
Что сделать:
- поднять логи съёмщика за 16–23 октября;
- отдельно посчитать долю 429;
- повторить проверку подозрительных запросов через мобильный интернет или другой источник.
Источник: vc.ru, исследование Андрея Калашникова.
3. Как строить структуру сайта под ИИ-поиск
Классическая модель «одна посадочная — один ключ из Вордстата» хуже подходит для генеративной выдачи. ИИ может разбить исходный вопрос на десяток уточняющих подзапросов — так называемый query fan-out — и собрать итоговый ответ из нескольких автономных фрагментов примерно по 300–500 слов.
26 октября SEO-специалист Виктор Петров показал на vc.ru, как под такую механику собирать структуру сайта.
В его пайплайне используются бесплатные и открытые инструменты:
- SiteAnalyzer SEO Tools 4.0 — для выгрузки веера подзапросов через браузерное расширение;
- Textrazor, до 500 запросов в день бесплатно, либо связка spaCy + OpenTapioca — для сущностей и Wikidata ID;
- BERTopic и HDBSCAN — для группировки тем;
- Ollama — для названий кластеров и подготовки контент-брифов.
Но сама автоматизация здесь не заменяет проверку. Каждый кластер автор предлагает сверять по топ-30 выдачи: минимум три общих URL должны появляться на выборке из 3–5 запросов. Иначе алгоритм может собрать в одну группу просто похожие по словам, но разные по смыслу запросы.
Есть и более бытовая проблема — омонимы. В одном из примеров Textrazor принял техническую аббревиатуру «ВБИ» — взрывобезопасное исполнение — за название организации.
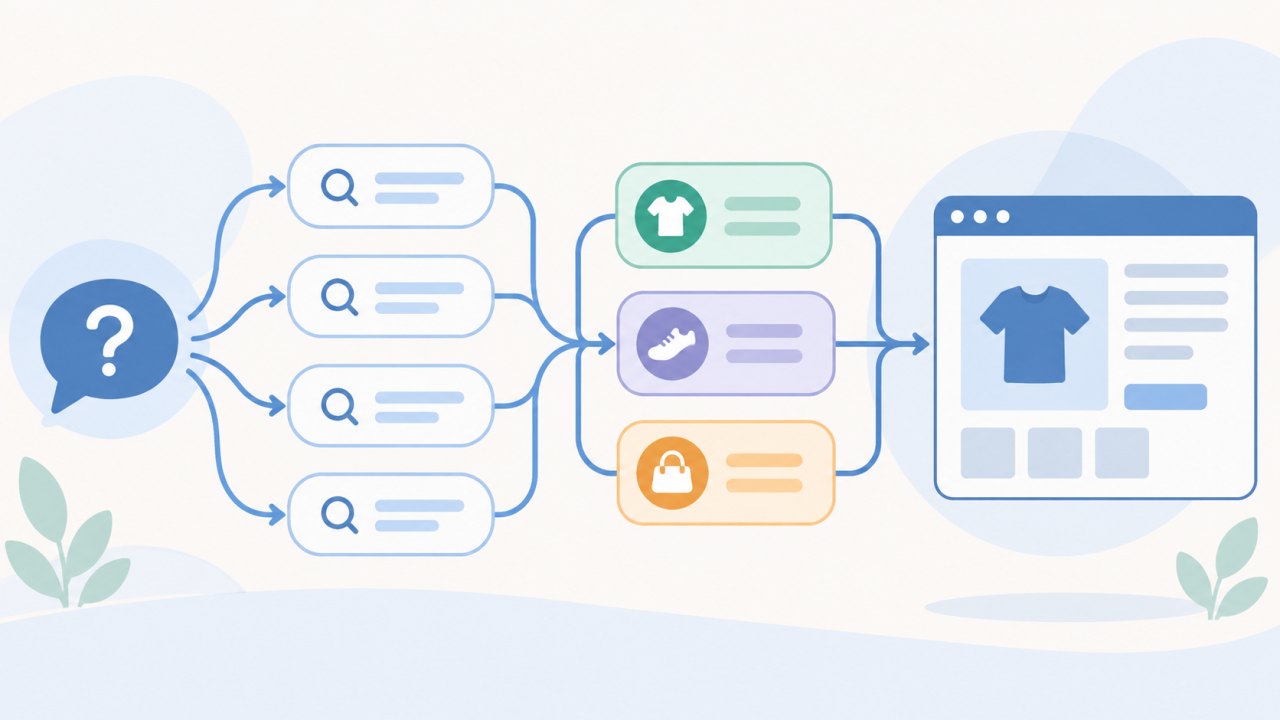
Для первого эксперимента достаточно одного коммерчески важного кластера на 100–200 запросов. Повторите основные запросы 3–4 раза через ИИ-поиск, выпишите повторяющиеся ветки и отметьте, какую их долю покрывают текущие страницы. В кейсе автора граница в 20% используется как сигнал явного пробела: тогда структуру имеет смысл расширять отдельными блоками-ответами по 300–500 слов.
Через месяц можно сравнить долю цитирований и переходы.
Источник: vc.ru, разбор Виктора Петрова.
4. 10 200 карточек запчастей: где ИИ начинает выдумывать товарные свойства
В интернет-магазине сельхоззапчастей было 10 200 товаров в 61 категории. В исходной базе для многих карточек были только артикул и название вроде «Фиксатор БДТ 1.502 (БДТ-7А)».
29 октября руководитель агентства Direct Marketing Сергей Морозов рассказал на SEOnews, как с июня по сентябрь команда генерировала через агента на базе Claude H1, title, description, описания и характеристики.
Позиции и трафик автор пока не оценивает: времени после запуска прошло мало. Зато на тестах хорошо видно, где без контроля возникает проблема.
На первом прогоне проверили 5 342 карточки из 6 650 сгенерированных. Агент сам добавлял формулировки вроде «оригинальная запчасть», «гарантия качества» и «быстрая доставка по России» — хотя этих данных в исходной базе не было.
После введения стоп-слов на новой партии из 500 товаров появилась другая ошибка: в 258 карточках, то есть в 52%, модель подтянула характеристики из названия родительской категории. А во всех 13 карточках раздела «Вкладыши» самостоятельно расшифровала сокращения «шат» и «кор».
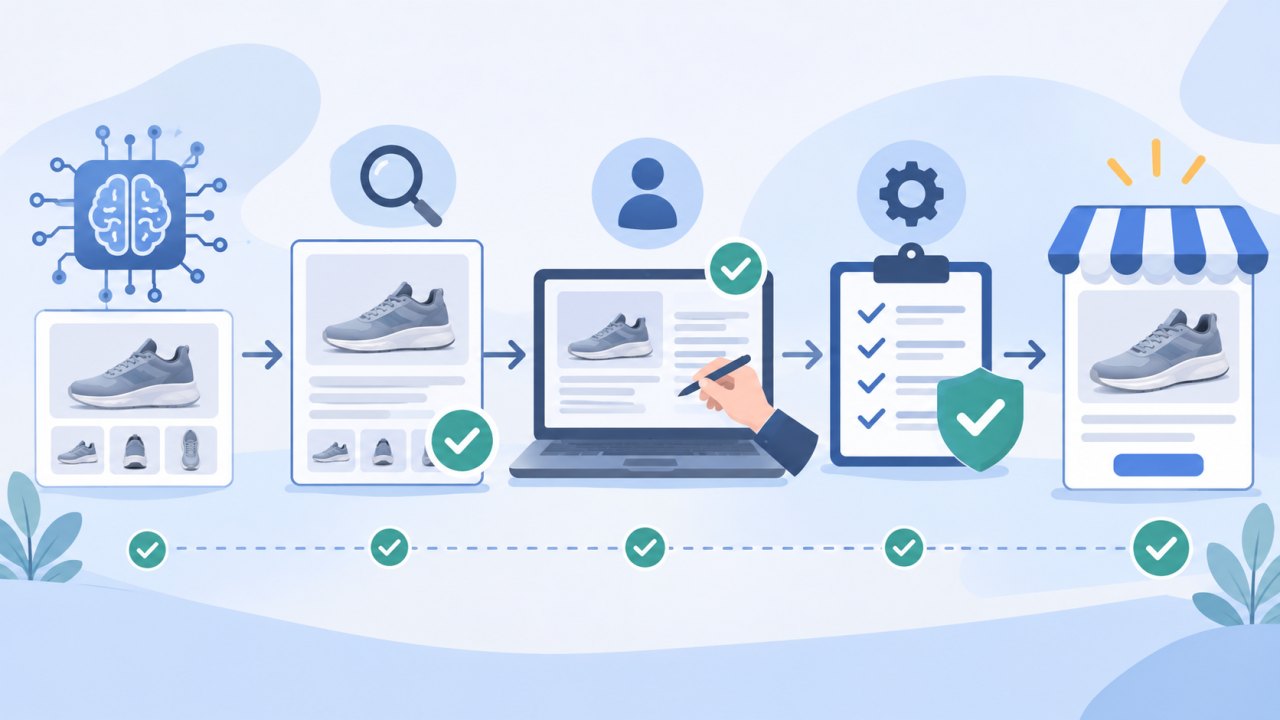
Поэтому после июльского пилота на 200 товарах генерацию всего каталога сразу остановили и перешли на партии по 500–1 000 карточек. В процесс добавили четыре фильтра:
- программный валидатор с автоматической перегенерацией при ошибке;
- ручной разбор спорных строк в Excel;
- приёмку таблицы специалистом клиента;
- построчную сверку живых страниц после выгрузки через REST API.
Практический вывод простой: LLM нельзя считать источником фактов о товаре, если фактов нет в исходных данных.
Перед первой выгрузкой в CMS стоит заложить в обработку:
- стоп-лист для слов вроде «оригинал», «гарантия», «в наличии», «доставка», если таких данных нет в фиде;
- посимвольную проверку артикулов, дробей и слешей;
- запрет на наследование характеристик из названия категории;
- пилот на 100–200 карточках с обязательной оценкой доли брака продуктовым специалистом.
Источник: SEOnews, кейс Сергея Морозова.
5. Google, Bing, OpenAI и Anthropic договорились о едином токене для robots.txt
Сейчас правила для ИИ-ботов часто выглядят как набор отдельных директив под каждого поставщика. 30 октября Google и Microsoft Bing объявили о добровольной поддержке черновика стандарта рабочей группы AIPREF в IETF. К инициативе также присоединились OpenAI и Anthropic.
Предлагаемый механизм — единый токен User-agent: __usage_ai-training, который позволит разрешать или запрещать использование сайта для обучения сразу участникам соглашения.
При этом явная директива для конкретной компании сохраняет приоритет. То есть, если в robots.txt отдельно указан токен вроде Google-Extended, он не будет автоматически отменён общей настройкой.
Microsoft одновременно разделил ИИ-контроль на три уровня:
- AI Training — обучение моделей;
- AI Grounding — сбор информации для ответов ИИ-поиска;
- Limited Grounding — передача данных внешним партнёрам.
Запрет на обучение, по объяснению Microsoft, сам по себе не исключает сайт из ответов Copilot и не меняет обычное ранжирование в Bing.
Новый токен начнёт учитываться в начале 2027 года. Для Bing временные настройки для сайтов со старыми директивами NoArchive и NoCache должны открыться 15 декабря 2026 года, а обработка новых правил при обходе стартует 1 февраля 2027 года.
Поэтому менять рабочий robots.txt на новый токен уже сейчас не стоит: до начала 2027 года боты его просто проигнорируют.
Пока полезнее проверить действующие директивы. В том же анонсе Google отдельно отметил, что сайты с разрешённым Google-Extended сохраняют возможность показываться и получать переходы в приложениях Gemini.
Источник: Google Search Central Blog, Search Engine Roundtable.
6. Gemini перестал добавлять UTM — и это прячет часть AI-трафика
30 октября Search Engine Roundtable опубликовал сразу два замера, которые усложняют оценку переходов из генеративного поиска.
Первый касается Gemini. Аналитик Натзир показал, что примерно с 28 сентября сервис перестал добавлять к ссылкам utm_source=gemini. Эксперимент с такой разметкой продолжался около трёх недель в сентябре.
На десктопе реферер gemini.google.com по-прежнему может передаваться. А приложение Gemini на iOS открывает сайты во встроенном WebView без реферера. Поэтому такие переходы в GA4 и Яндекс Метрике могут попадать в Direct, а дополнительный след остаётся в серверных логах по юзерагенту GeminiiOS.
Второй эксперимент провёл Сайрус Шепард. Он временно отключил свой сайт от показов в AI Overviews и AI Mode через настройки Search Console, чтобы оценить кликабельность ИИ-блоков.
Получился расчётный CTR около 0,9% при доле ИИ-показов около 8% всех показов сайта. Но интереснее другое: после отключения ИИ-видимости просели и обычные органические клики по тем же страницам.
Шепард связывает это с эффектом «ореола выдачи» — когда упоминание сайта или бренда в верхнем ИИ-блоке повышает доверие и вероятность клика по тому же домену в обычной органике.
Ограничение здесь существенное: исследование проведено на одном сайте, поэтому 0,9% нельзя переносить на весь рынок.
Что проверить:
- не ищет ли ваш дашборд Gemini только по
utm_source=gemini; - попробуйте сегментацию по рефереру
gemini.google.com; - в access-логах за октябрь посчитайте запросы с
GeminiiOS.
Источник: Search Engine Roundtable.
7. Фальшивый Googlebot, WAF и неожиданно важная проверка фавиконки
Подделать User-Agent под Googlebot технически несложно, и ИИ-скрейперы этим пользуются. 30 октября Гэри Илш рассказал в подкасте Odys, что небольшие скрейперы могут выдавать себя за поискового робота, обходить простые правила WAF и CDN, игнорировать robots.txt и создавать лишнюю нагрузку.
На honeypot-сайтах, которые использовал сам Илш, запросы с маской Googlebot массово приходили с посторонних IP. Похожие наблюдения в тот же период обсуждали вебмастера на российских форумах.
При этом есть важная оговорка: для небольшого сайта, который не испытывает заметной нагрузки от роботов, усложнять защиту может быть не нужно.
Надёжнее проверять не только заголовок User-Agent, но и источник запроса. Для Google это можно делать через обратный DNS по доменам .googlebot.com и .google.com либо по официальным диапазонам IP. Подозрительные обращения от Яндекса можно дополнительно проверять через восстановленный 16 октября инструмент «Проверка IP-адреса» в Вебмастере.
Вторая тема — фавиконки. В справке Google, обновлённой 27 октября, уточнено: Googlebot должен пройти всю цепочку редиректов от главной страницы до страницы, где указана иконка, а Googlebot-Image — получить сам файл изображения без блокировки robots.txt.
Поэтому на сайтах с гео- или языковыми редиректами стоит проверить не только конечный URL, но и всю цепочку ответа для Googlebot, а также доступность файла фавиконки для Googlebot-Image.
Источник: Search Engine Roundtable, документация Google.
Что проверить за неделю
Если не хочется разбирать все семь пунктов сразу, достаточно начать с трёх направлений:
- Яндекс. Проверить «Безопасность и нарушения», восстановленные API и логи съёмщика позиций. Особенно внимательно посмотреть на 429 и ложные статусы «Не найдено» за 16–23 октября.
- ИИ-поиск. Взять один коммерческий кластер на 100–200 запросов и посмотреть, какие дополнительные ветки формирует ИИ-поиск и какие из них уже покрывает сайт.
- Аналитика и боты. Найти в access-логах запросы с
GeminiiOS, а самые активные обращения от поисковых роботов проверить по rDNS и IP-диапазонам, а не только по User-Agent.
Комментарии
Написать комментарийВойти