Парсинг SHEIN: как проверить данные перед анализом цен
Парсинг SHEIN помогает перенести товары в таблицу, но перед сравнением цен нужно проверить саму выгрузку: когда она получена, в какой валюте указаны суммы и завершился ли сбор. Разберём небольшой сценарий для аналитика: получить файл, проверить его состояние и подготовить CSV с замечаниями к каждой строке. В основе примера лежит открытый скрепер SHEIN на GitHub. Для разбора используется сохранённый образец от 30 сентября 2026 года; новый сбор с сайта для статьи не проводился.
Парсинг SHEIN с проверкой результата: шесть шагов
- Выбрать один поисковый запрос, категорию или карточку товара.
- Установить скрепер и настроить доступы через файл .env.
- Начать с небольшой выборки до 20 товаров.
- Проверить код завершения и служебный файл .meta.json.
- Проверить идентификаторы, валюту, цены и дату в строках.
- Сохранить CSV для анализа, оставив исходную выгрузку рядом.
Самое неудобное здесь: файл на диске может выглядеть совершенно нормально после неудачного обновления. По документации скрепер сохраняет предыдущий результат, если новый запуск не получил ни одного товара. Поэтому наличие CSV или JSON само по себе ничего не говорит о свежести данных.
Что передать скреперу и что получить
| Вход | Результат | Что проверить |
|---|---|---|
| Поисковый запрос, например summer dress | Строки товаров из выдачи | Запрос, объём выборки и завершение сбора |
| Адрес категории | Товары из категории | Совпадение категории и полноту выгрузки |
| Ссылка на карточку | Данные товара из JSON-LD | Источник цены и особенности вариантов |
В строках есть название, бренд, текущая и первоначальная цена, скидка, рейтинг, число отзывов и флаг наличия. Но это не подробная база всех размеров и цветов: sku соответствует товару в целом. Если цена взята как минимальная среди вариантов, поле price_source содержит json_ld_min_variant. Сравнивать такую сумму с ценой конкретного размера без дополнительной проверки я бы не стал.
Документация ориентирована на us.shein.com. Другие региональные сайты не проверены, поэтому переносить выводы на цены SHEIN во всех странах нельзя.
Установка и первый файл
Проект рассчитан на Python 3.9 и новее. Ниже команды из README для оболочки Bash, например в Linux или macOS; для PowerShell активация окружения и копирование файла отличаются.
git clone https://github.com/2scraper/shein-scraper.git
cd shein-scraper
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements-playwright.txt
playwright install chromium
cp .env.example .env
Доступы записывают в .env: TWOCAPTCHA_KEY для задач 2Captcha, SHEIN_CDP_ENDPOINT для подключения браузерного профиля и SHEIN_PROXY при использовании прокси. Реальные значения нельзя переносить в статью, скриншоты и общедоступный репозиторий. Без TWOCAPTCHA_KEY можно запустить локальный браузер и собрать доступные страницы; платное решение головоломок без ключа недоступно. Успешный сбор не гарантирован: сайт может потребовать проверку или ограничить запросы. Подробный гайд «How to scrape SHEIN» на сайте 2Captcha можно использовать как полное описание всех опций.
Команда небольшого запуска из документации:
python3 playwright_scraper.py --query "summer dress" --max-results 20При получении строк результат записывается в shein_results.json, а сведения о запуске в shein_results.json.meta.json. Для CSV у проекта есть параметры --format csv и --out с именем файла. Число 20 здесь ограничивает выборку; оно не обещает, что будут найдены ровно 20 товаров или весь ассортимент по запросу.
Дальнейший пример обработки работает с sample_output.json из репозитория. Его можно повторить без запуска браузера и запросов к SHEIN.
Проверка начинается до открытия таблицы
Сначала нужно сопоставить результат текущего запуска с его кодом завершения и служебным файлом. Код 0 означает завершённый сбор, 6 — частичный результат, а 3 указывает на блокировку или ограничение запросов без полученных строк. В .meta.json стоит проверить статус, причину остановки stop_reason, количество товаров и сведения об ограничении выборки. Сам файл содержит также контрольную сумму результата.
При коде 6 таблицу можно изучать, но использовать её как полную выборку нельзя. Например, средняя цена по нескольким полученным строкам не описывает всю категорию. Если новый запуск не собрал данные, предыдущий CSV-файл может сохраниться. Поэтому нужно проверить дату и состояние именно нового запуска, а не просто открыть знакомое имя файла.
Есть и техническая причина неполноты. Выдача SHEIN загружается при прокрутке, а первые примерно 20 товаров находятся во встроенных данных страницы. Получение последующих порций в README обозначено как непроверенное; число строк нельзя заранее приравнивать к размеру каталога.
Откуда берутся цены и почему сбор останавливается
Цепочка обработки устроена так: браузер открывает страницу, скрепер извлекает данные товаров, приводит их к общей структуре и сохраняет результат вместе со сведениями о запуске. Для выдачи используется встроенный объект window.gbRawData, для отдельных карточек — JSON-LD.
Вместо товаров сайт иногда показывает /risk/challenge. Скрепер распознаёт эту проверку; задачи с сеткой изображений и последовательностью значков обрабатываются через 2Captcha. Другая ситуация, /risk/action/limit, означает ограничение запросов: решать головоломку здесь нечего. Эти состояния важно различать, когда в таблице оказалось меньше строк, чем ожидалось.
В проекте есть лимит платных решений --max-solves: по умолчанию 8, значение 0 запрещает платные решения. Это относится именно к решениям задач, а не ко всем возможным расходам на браузер или прокси. В README приведена проверка от 30 сентября 2026 года: защиту прошли 3 из 5 свежих американских профилей Scraping Browser API, каждый на третьем раунде. Это результат авторов репозитория, а не новый запуск для статьи; он не гарантирует успешного сбора с другим профилем.
Что проверить в одной строке
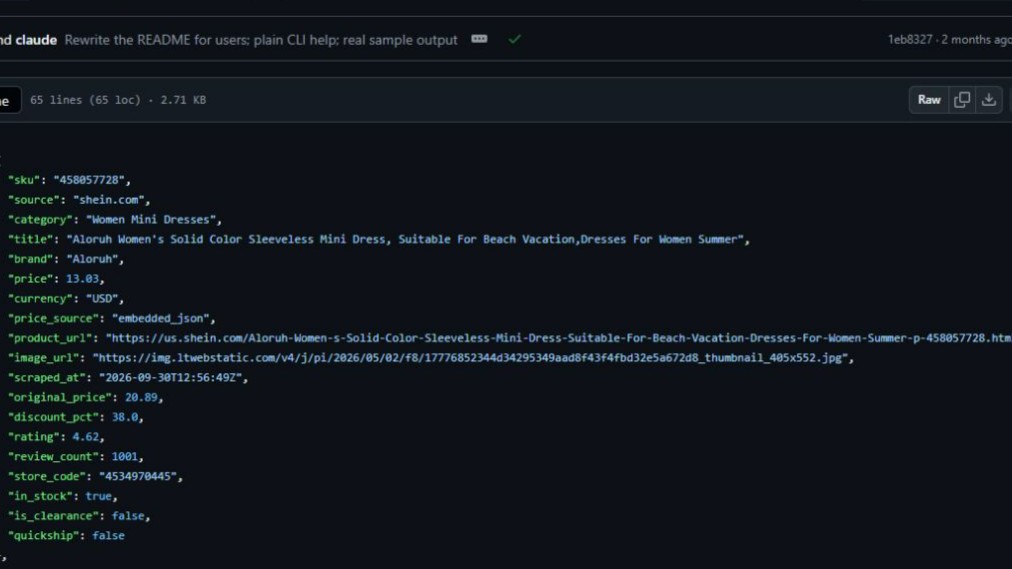
Вот часть полей первой записи sample_output.json, без изменения значений:
{
  "sku": "458057728",
  "price": 13.03,
  "currency": "USD",
  "price_source": "embedded_json",
  "scraped_at": "2026-09-30T12:56:49Z",
  "original_price": 20.89,
  "discount_pct": 38.0,
  "rating": 4.62,
  "review_count": 1001,
  "in_stock": true
}
Для сверки товаров нужен sku. Для сравнения сумм нужны как минимум price и currency, а price_source помогает понять происхождение цены. Дата scraped_at показывает время сохранённого наблюдения. Скидка и первоначальная цена могут быть null, если скидки нет; заменять такой пропуск нулём без объяснения не стоит.
Рейтинг и число отзывов тоже решают разные задачи. В образце у товара 499485260 рейтинг 4,8 при 143 отзывах, а у 458057728 рейтинг 4,62 при 1001 отзыве. Эти значения сами по себе не доказывают, какой товар лучше или популярнее. Тексты отзывов скрепер в показанной структуре не выгружает.
CSV с замечаниями к данным
Сохраним следующий код как audit_sample.py в папке репозитория. Это дополнительная обработка для статьи, а не встроенная команда скрепера. Используется только стандартная библиотека Python, отдельные пакеты не нужны.
import csv
import json
from collections import Counter
from pathlib import Path

rows = json.loads(Path("sample_output.json").read_text(encoding="utf-8"))
counts = Counter(row.get("sku") for row in rows)
fields = ["sku", "price", "currency", "price_source", "scraped_at", "check"]

def safe_cell(value):
    if isinstance(value, str) and value.startswith(("=", "+", "-", "@", "\t", "\r", "\n")):
        return "'" + value
    return value

with Path("sample_audit.csv").open("w", encoding="utf-8-sig", newline="") as file:
    writer = csv.DictWriter(file, fieldnames=fields)
    writer.writeheader()
    for row in rows:
        notes = []
        for key in ("sku", "currency", "price_source", "scraped_at"):
            if not row.get(key):
                notes.append("missing " + key)
        if type(row.get("price")) not in (int, float) or row["price"] < 0:
            notes.append("invalid price")
        if counts[row.get("sku")] > 1:
            notes.append("duplicate sku")
        result = {key: safe_cell(row.get(key)) for key in fields[:-1]}
        result["check"] = "; ".join(notes) or "basic checks passed"
        writer.writerow(result)
Запуск обработки:
python3 audit_sample.pyНа сохранённом образце получается sample_audit.csv с тремя строками. Во всех трёх заполнены проверяемые поля, указана валюта USD, цены неотрицательные, повторяющихся sku нет. В столбце check стоит basic checks passed. Это результат локальной проверки файла, а не подтверждение актуальности цен на сайте.
Такую таблицу удобно передать аналитику вместе с оригиналом. Скрипт проверяет только перечисленные условия: он не устанавливает, свежая ли дата, правильно ли разобрана карточка и завершился ли сбор. Проверка .meta.json остаётся отдельным шагом. На мой взгляд, эта граница должна быть видна прямо в инструкции, иначе отметка «проверено» создаёт лишнюю уверенность.
Мониторинг цен требует сопоставимых запусков
Для отслеживания изменений сохраните результаты в разные файлы. В проекте есть инструмент сравнения:
python3 diff_runs.py monday.json tuesday.jsonОн сопоставляет товары по sku и проверяет совместимость запросов, рынков, параметров сортировки и метаданных. Изменение валюты отмечается отдельно как currency_changed, а не выдаётся за изменение цены. Если выборку ограничили через --max-results, исчезновение товара из верхних N позиций обозначается left_selection: это ещё не означает удаления товара из каталога.
Параметр --sort пока лишь записывается в результаты и не передаётся SHEIN. Поэтому нельзя описывать его как работающую сортировку выдачи по цене.
Вопросы перед использованием выгрузки
Можно ли получить весь каталог SHEIN в CSV?
Нет, документация этого не гарантирует. Получение товаров после первой порции примерно из 20 записей не подтверждено, а частичный запуск нужно отличать от завершённого.
Это официальный SHEIN API?
Описанный инструмент извлекает данные из страниц через браузер. Подключение к официальному товарному API SHEIN в этом сценарии не используется.
Можно ли выгрузить отзывы SHEIN?
Тексты отзывов в показанную выгрузку не входят. В образце есть рейтинг и количество отзывов, но для анализа содержания отзывов этих данных недостаточно.
Можно ли сравнить цены разных размеров?
Приведённая выгрузка содержит одну строку на товар, а не на каждое сочетание размера и цвета. Значение json_ld_min_variant указывает на минимальную цену варианта; конкретные размеры потребуется проверять отдельно.
Можно ли считать цены из примера сегодняшними?
Нет, образец датирован 30 сентября 2026 года. Он подходит для проверки обработки и формата, но не для вывода о текущих предложениях SHEIN.
Перед самостоятельным сбором проверьте правила сайта и robots.txt, ограничьте частоту запросов и работайте с публичными данными. Если задача затрагивает персональные данные, отдельно проверьте применимость требований GDPR и 152-ФЗ; публичная доступность сведений не заменяет такую проверку. В примере используются сведения о товарах без личных данных покупателей.
Для повторения начните с файлов проекта на GitHub: образец уже подходит для локального аудита. Описание инструмента есть также на странице скрепера SHEIN. К сравнению цен переходите после проверки свежести, валюты и состояния сбора.
Комментарии
Написать комментарийВойти