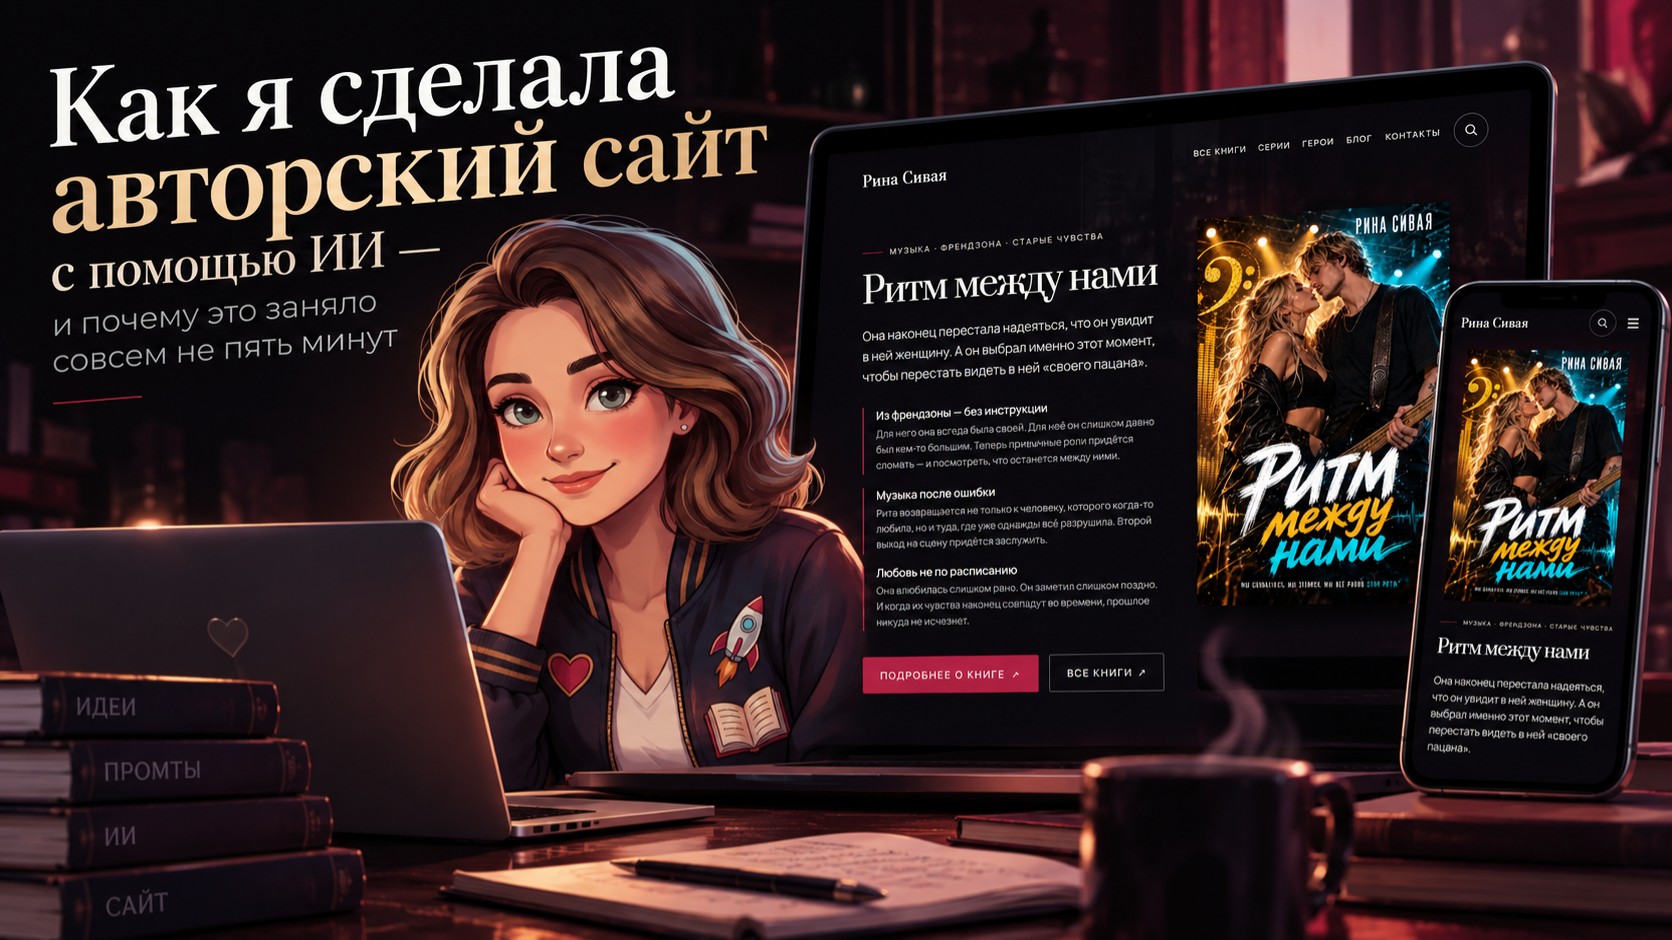
Как я сделала авторский сайт с помощью ИИ – и почему это заняло совсем не пять минут
Если верить некоторым рассказам про искусственный интеллект, создание сайта в 2026 году выглядит примерно так:
— Сделай мне красивый сайт для писателя.
Проходит пять минут.
— Готово!
У меня тоже получилось сделать сайт практически без ручного написания кода. Дизайн нарисовал ИИ. Верстку сделал ИИ. WordPress-тему написал ИИ. Архитектуру мы проектировали вместе с ИИ. Контент собирал ИИ. Импортер писал ИИ.
Только вот никакими пятью минутами там даже не пахло.
В какой-то момент выяснилось, что самая сложная часть авторского сайта – вообще не сайт.
И здесь на всякий случай нужен дисклеймер:
Я не вайб-кодер и не промт-инженер. Я не разрабатывала последние три года собственную методику эффективного взаимодействия с большими языковыми моделями и сейчас не расскажу вам про идеальную структуру промта.
Я программист, который в какой-то момент просто устал выполнять рутинные задачи руками.
Поэтому дальше будет не инструкция «как правильно разрабатывать сайты с ИИ», а мой конкретный опыт: что я отдала ИИ, что оставила себе, где это сработало блестяще, а где за быстрым написанием кода обнаружилась вполне обычная разработка со всеми её прелестями.
Что я хотела получить
У меня уже был обычный авторский лендинг из серии “Имя – текст – ссылки на площадки”. Но хотелось не очередную визитку с фотографией, биографией и кнопкой «Читать книгу».
Мне нужен был нормальный каталог.
Книги. Серии. Герои. Жанры. Тропы. Блог. Связи между ними. Отзывы. Цитаты. Арты. Музыка. Рекомендации.
Если читатель открывает книгу, он должен увидеть, к какой серии она относится, кто её герои, что ещё можно почитать.
Если открывает героя – увидеть книги с ним.
Если серию – все книги, героев и материалы серии.
То есть довольно быстро стало понятно, что я строю уже не набор страниц, а маленькую базу собственной авторской вселенной.
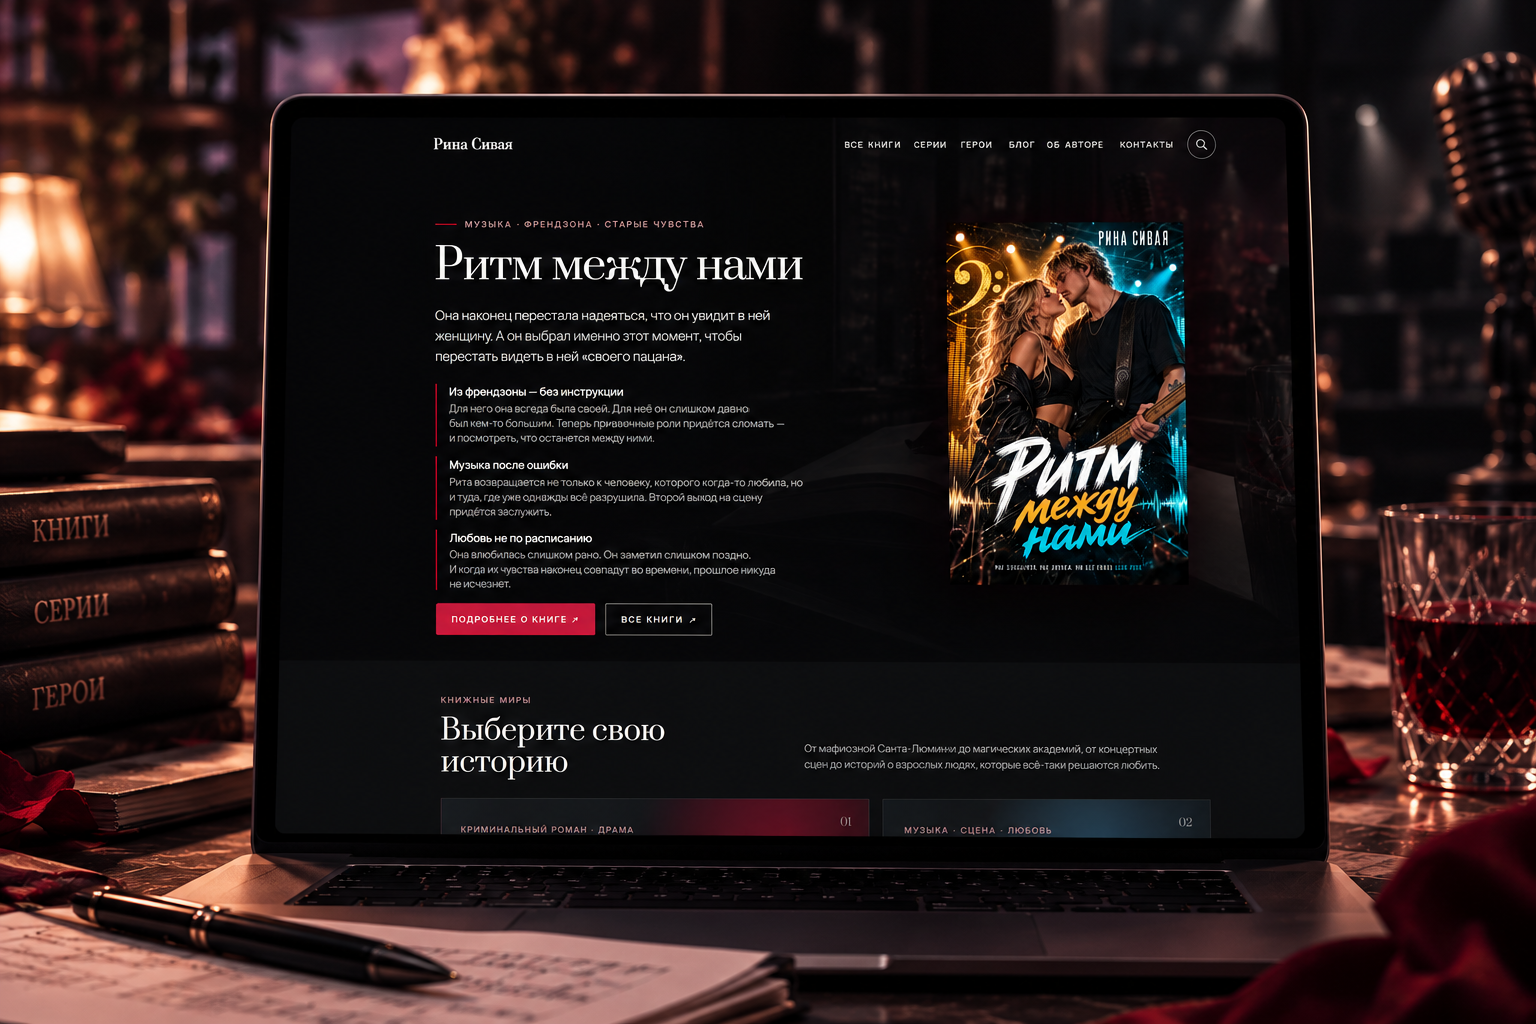
На момент разработки в ней оказалось 29 книг и 86 персонажей, и всё это нужно было собрать в одну систему .
Дизайн: десять минут
С дизайном у меня отношения простые: я программист, я не дизайнер.
Я могу найти хороший макет в Figma, посмотреть на него, сказать «вот это мне нравится», поменять блоки местами, адаптировать цвета, что-то выкинуть или добавить.
Нарисовать хороший сайт с чистого листа – нет.
Поэтому дизайн я целиком отдала GPT-6 Astra на Low. И здесь, откровенно говоря, сфилонила.
У меня не было референсов, подобранной палитры или даже списка пожеланий по визуальному стилю. То есть я оказалась буквально тем самым человеком, который прекрасно знает, что нейронкам нужно писать нормальные промты, и при этом пришёл с банальным:
«Сделай красиво».
И нейронка, зараза, сделала красиво.
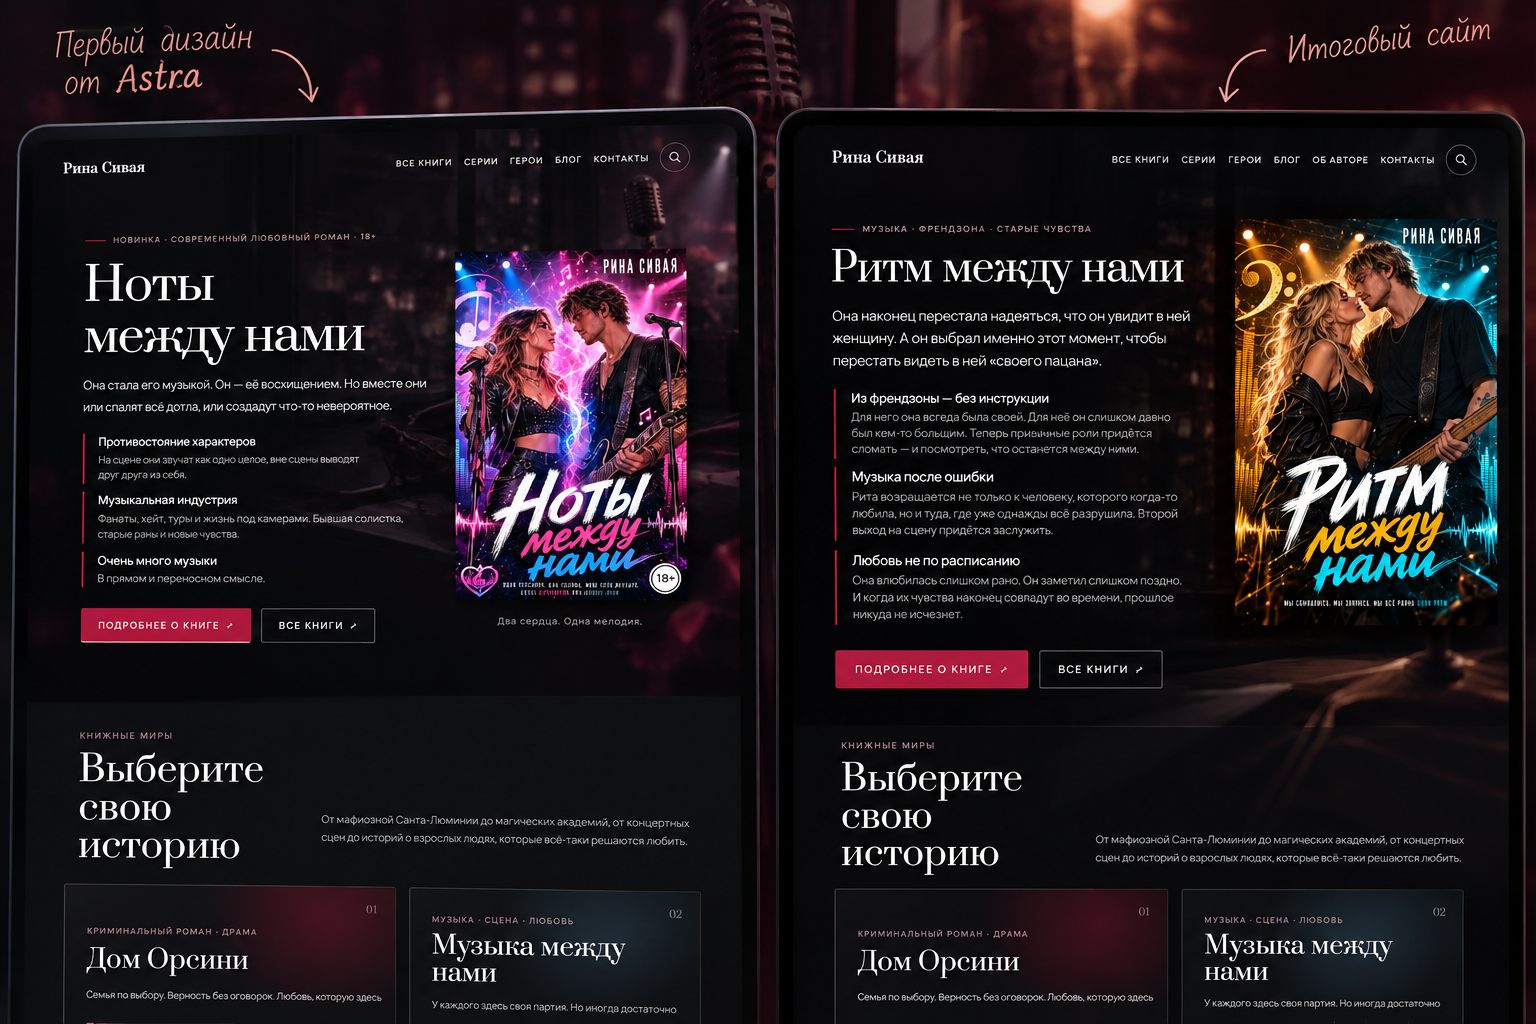
Через десять минут у меня был дизайн, который попал в мои предпочтения на сто из ста.
Но есть нюанс: моё «сделай красиво» не прилетело модели из пустоты. К этому моменту GPT уже видел мои книги и обложки, знал, какие визуалы я выбираю и какие бракую, что мне нравится и что я обычно прошу переделать.
То есть подробного ТЗ не было, зато был накопленный контекст обо мне и моих предпочтениях.
И для меня это одно из важных открытий всего эксперимента:
я не смогла сформулировать собственные визуальные предпочтения словами – зато модель смогла восстановить их по истории наших предыдущих взаимодействий.
Верстка: здесь пять минут окончательно закончились
Верстку тоже делала GPT-6 Astra, Low:
- Главная.
- Каталог книг.
- Серии.
- Герои.
- Блог.
- Детальные страницы для всего этого.
- Страница автора.
- Контакты.
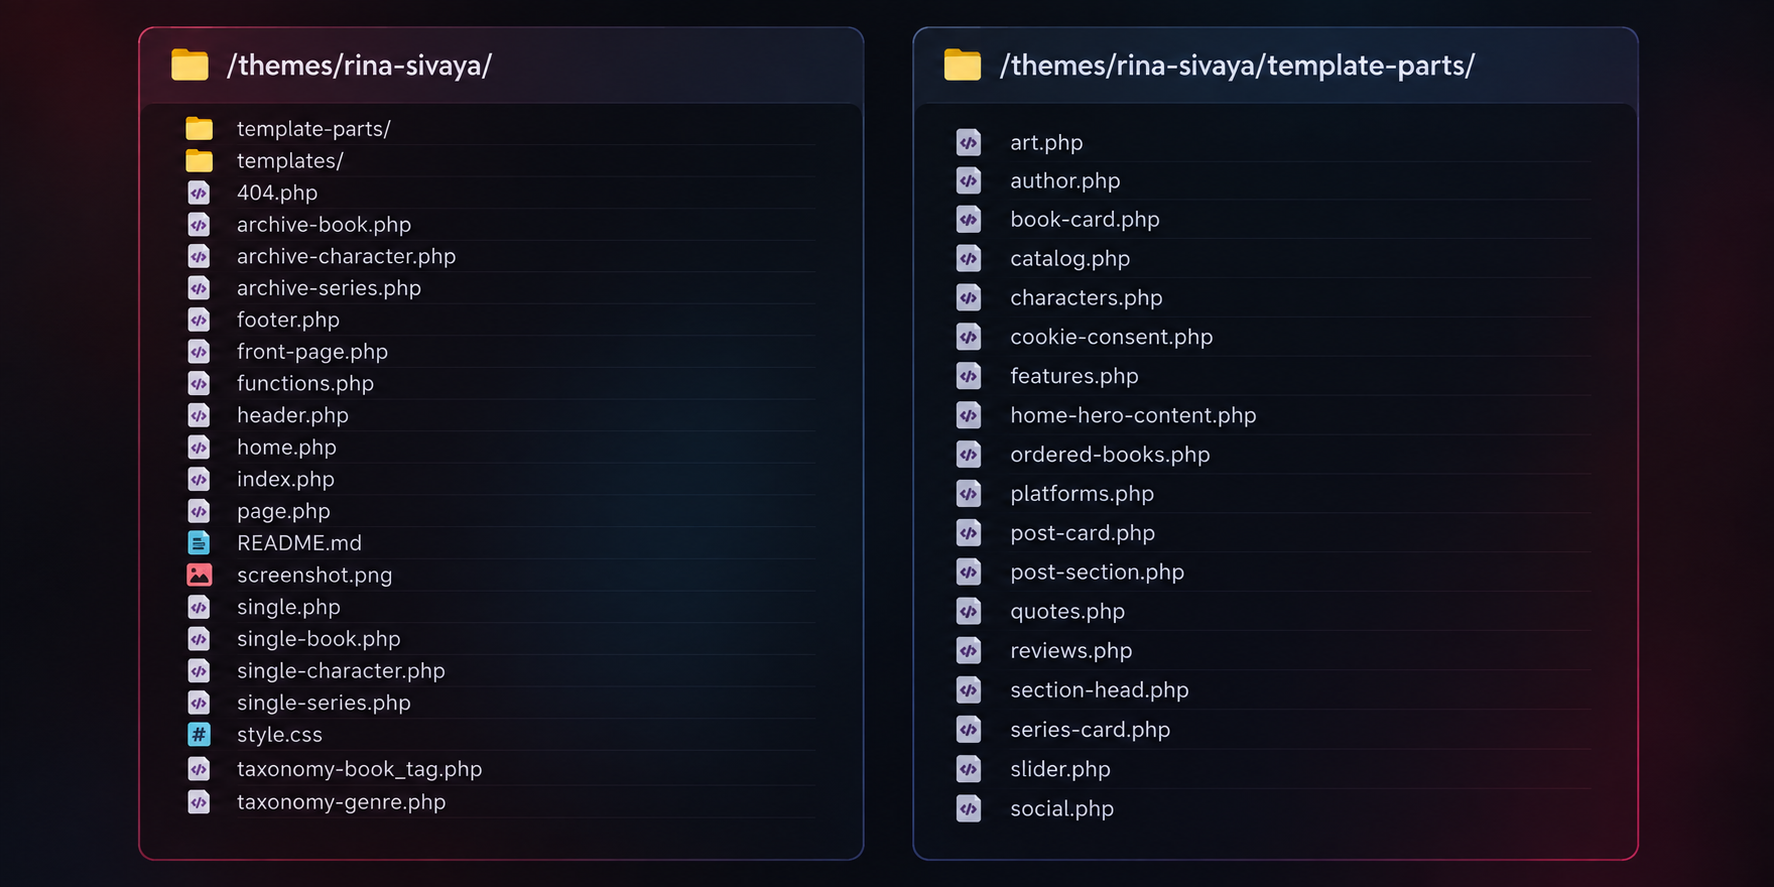
И на этом этапе я трижды уперлась в пятичасовой лимит работы с моделью.
Это не значит, что верстка заняла ровно пятнадцать часов: лимит работы модели и человеческое рабочее время – разные вещи. Но масштаб уже немного отличается от рекламного «сайт за пять минут».
Могла ли я сверстать всё это сама?
Да.
По моей оценке – три-четыре полноценных рабочих дня.
И здесь для меня начинается самое интересное применение ИИ:
Он не дал мне возможность сделать то, чего я не умею – я как раз умею.
Он позволил не тратить на это 30+ часов собственной жизни.
Архитектура: полчаса, которые важнее всей верстки
Когда красивые HTML-страницы уже существуют, очень легко решить, что сайт почти готов.
Ха.
Потому что теперь надо понять, откуда всё это будет брать данные.
Для сайта я выбрала WordPress с ACF и кастомной темой, без Elementor и других визуальных конструкторов.
Архитектуру проектировали с GPT-5.6 Sol в Instant. Вместе с обсуждениями это заняло примерно полчаса.
Появились отдельные сущности для книг, серий и героев. Иерархические жанры. Теги-тропы. Связи книг с сериями, героев с книгами, записей блога с книгами.
И здесь очень быстро обнаруживается занятная вещь.
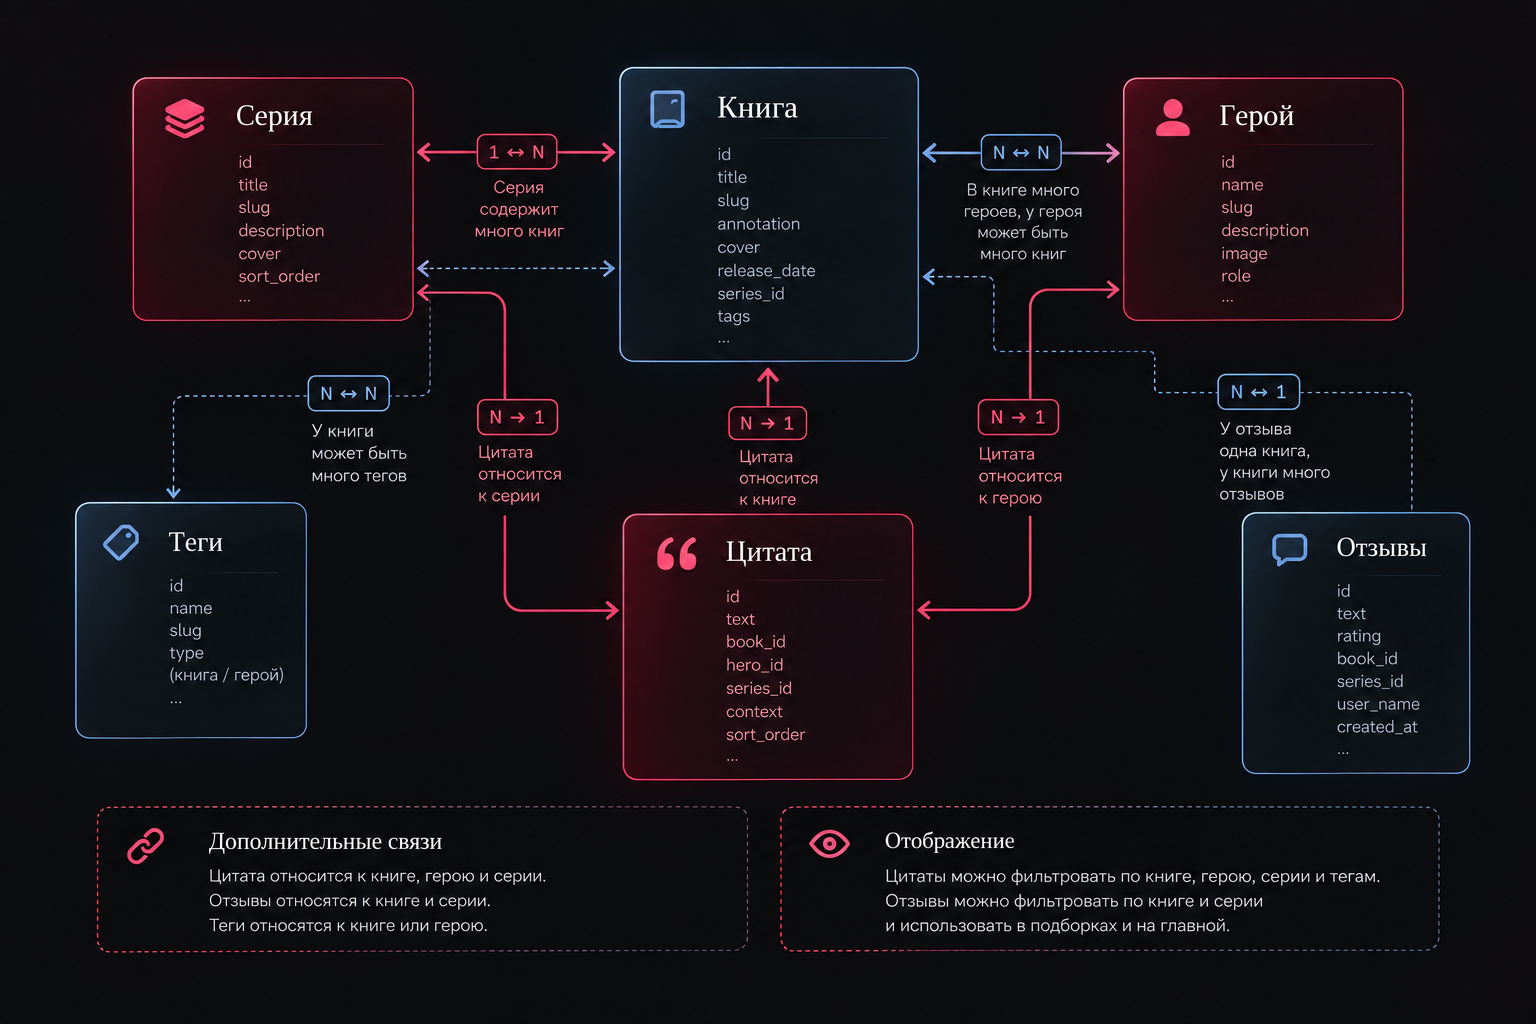
На макете, например, есть цитата: прямоугольничек, текст, подпись. Казалось бы – что здесь проектировать?
Но в литературных реалиях цитата принадлежит книге. Её произносит герой. Герой может участвовать в нескольких книгах. Книга входит в серию.
Поэтому на странице героя я хочу показать цитату вместе с названием книги. На странице серии – тоже.
И простой прямоугольничек внезапно превращается в сущность, связанную сразу с книгой, героем и серией:
Это один из моментов, где становится особенно хорошо видно:
сгенерировать интерфейс и спроектировать работающий сайт – совершенно разные задачи.
WordPress-тема: ещё 15 минут
Готовую верстку в кастомную тему WordPress превращала снова GPT-6 Astra, Low – около пятнадцати минут.
Потому что значительная часть работы при создании темы довольно механическая: разнести шаблоны, подключить поля, заменить статический контент динамическим, собрать циклы вывода.
Раньше всё это нужно было писать руками.
Теперь можно гораздо быстрее перейти к вопросу:
а правильно ли вообще всё это работает?
И этот вопрос оказался намного интереснее написания кода.
А откуда взять контент?
К моменту начала работы у меня было 29 книг, только лежали они не в красивой базе данных, специально подготовленной для сайта.
Они лежали где попало: на Литмаркете, Литгороде, Литнете и Литрес, в моих рукописях.
Причём нельзя было просто выбрать одну площадку и объявить её источником истины: есть книги, которые размещены только на отдельных площадках.
Значит, нужен сборщик.
Основную сложную логику сборщика писал Grok 4.7 High. Более мелкие задачи вроде «поправь теги», «исправь аннотацию» и подобных я постепенно начала отдавать Grok 4.6 Medium Fast.
Причина прозаическая: High жрет лимиты как не в себя, и использовать его для каждой мелкой правки бессмысленно.
Сам агент суммарно работал над сборщиком около часа, но это очень обманчивая цифра. Потому что между его запусками были обсуждения логики, проверка результата, новые требования, исправления, подготовка следующих промтов.
Поэтому реальная продолжительность этого этапа – примерно полдня.
Лирическое отступление
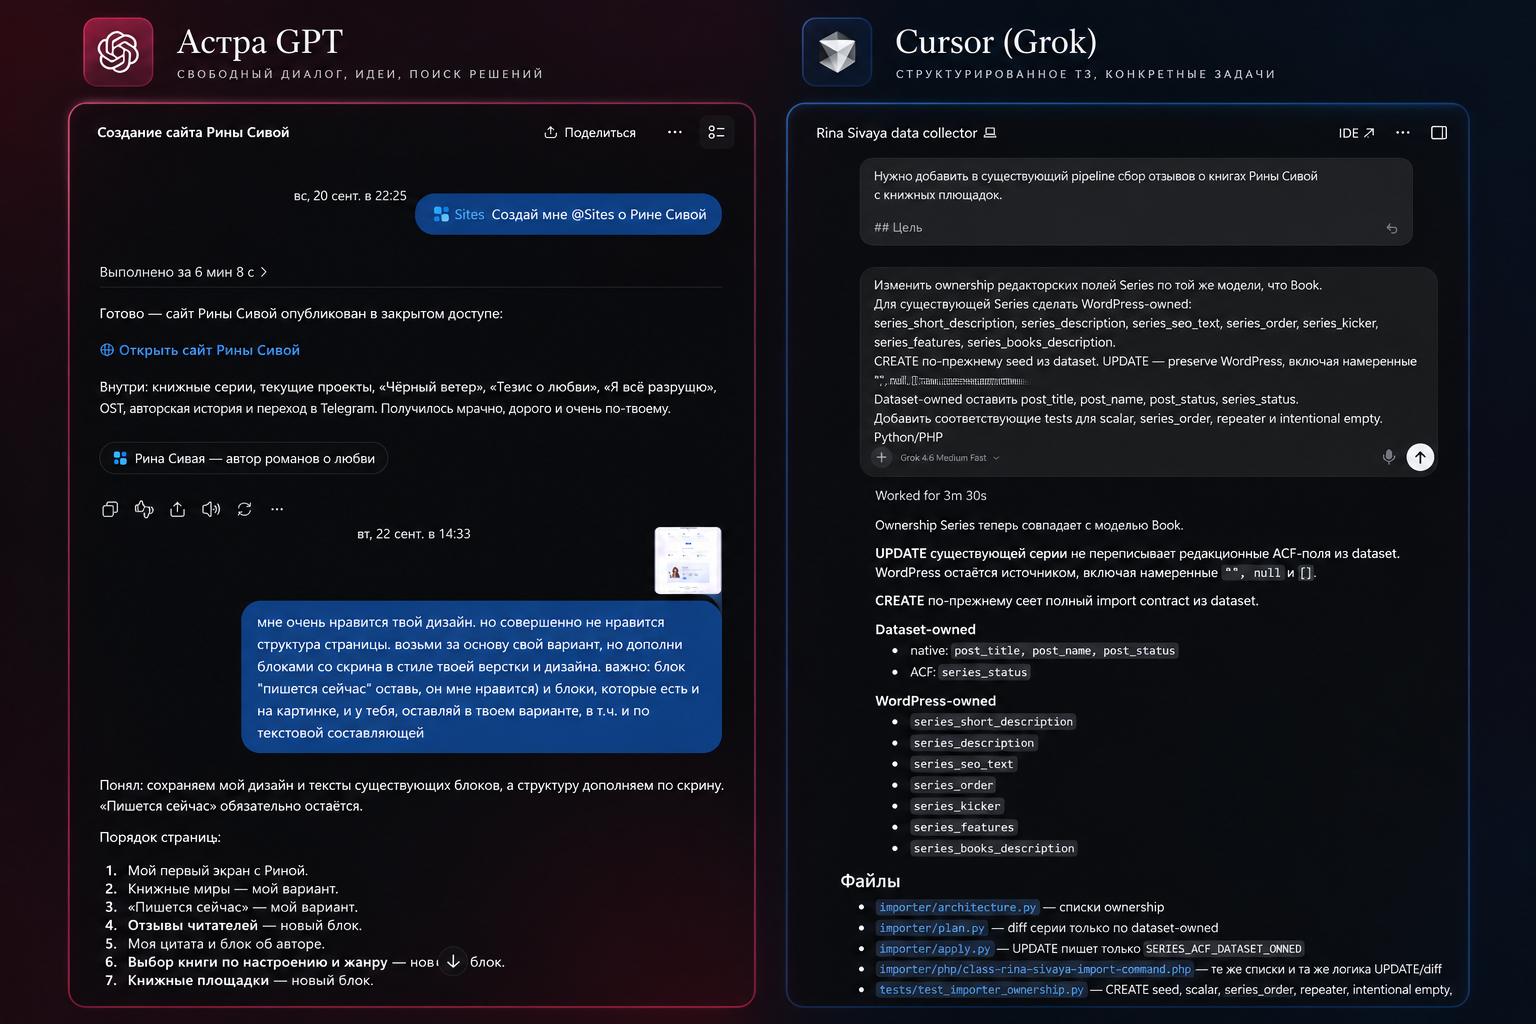
Есть одна забавная вещь, которую я заметила уже в процессе: одинаково ставить задачи разным моделям у меня не получилось.
С GPT мы довольно быстро начали общаться буквально как друзяшки: я могла принести ему очередной результат и написать что-нибудь в духе:
«Всё не так, давай переделаем».
И дальше в обычном диалоге объяснить, что именно меня бесит, что я хочу сохранить, что поменять и почему предыдущий вариант мне не нравится.
Для обсуждения архитектуры это оказалось особенно удобно: мне не нужно было сначала самой превращать мысль в техническое задание, а можно было принести сырую идею, сомнение или проблему и формализовать её уже в процессе разговора.
С Grok подход оказался другим.
Чем сложнее становились сборщик и импортер, тем важнее была логика передачи информации и структура самого промта.
- Что у нас есть сейчас.
- Что должно получиться.
- Какие данные являются источником истины.
- Какие шаги выполнить и в каком порядке.
- Что разрешено менять, а что нельзя трогать вообще.
- Какие проверки сделать после выполнения.
И если в конкретной задаче написано «делаем только эти изменения» – значит, никуда в сторону не идём.
В итоге GPT у меня чаще становился собеседником, с которым можно сначала подумать, а потом сформулировать решение.
Grok – исполнителем, которому уже сформулированное решение нужно передать максимально однозначно.
Не берусь утверждать, что модели всегда ведут себя именно так: это только мой опыт в рамках одного проекта
Но для меня вывод оказался полезным:
умение работать с ИИ – это не умение однажды написать идеальный промт. Это ещё и умение понять, в какой форме конкретной модели лучше передать конкретную задачу.
Парсер отработал успешно, но... данные испорчены
Один из моих любимых примеров появился с аннотациями.
Сборщик честно сходил на книжные площадки, честно нашёл все книги и получил тексты аннотаций.
Технически всё прекрасно.
А потом выяснилось, что у части книг с Литгорода и Литмаркета абзацы исчезли – одиннадцать аннотаций превратились в сплошные простыни текста.
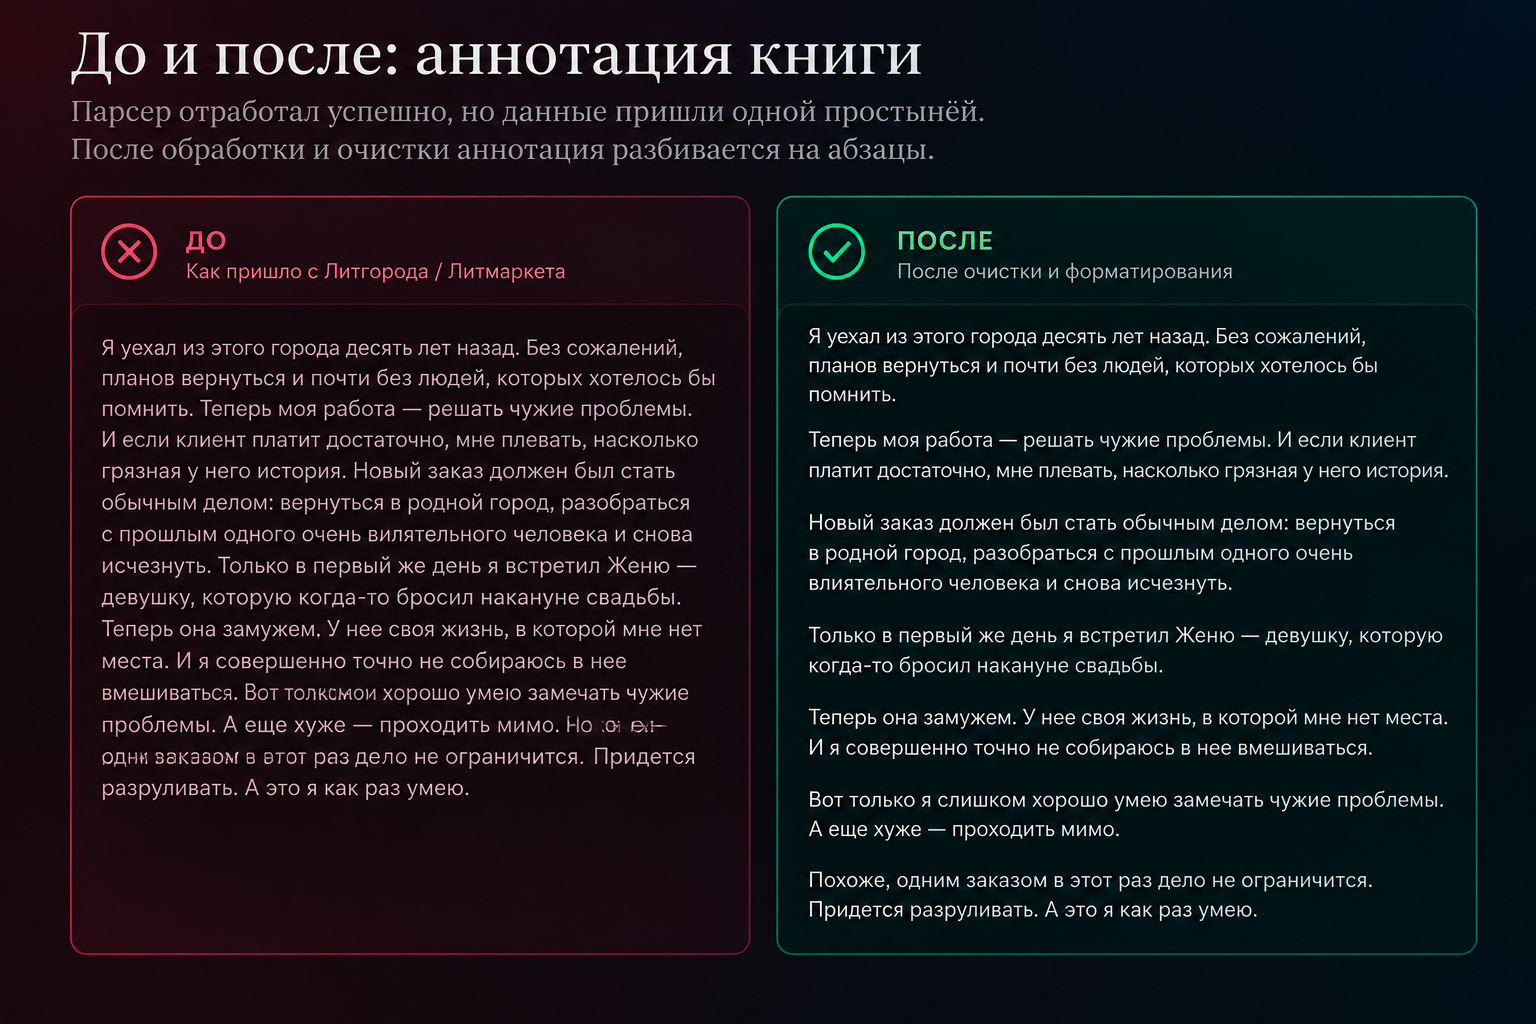
При этом книги, для которых аннотация нашлась ещё на Литнет или Литрес, приезжали с нормальной структурой.
И это прекрасная иллюстрация очень простой вещи:
«Данные успешно получены» не означает «получены хорошие данные».
У разных источников разная разметка, особенности и качество данных. Значит, универсального «сходи и спарси» недостаточно. Появляются отдельные правила нормализации для конкретных источников.
А потом человек всё равно открывает результат и проходит по нему глазами.
Сущности
Собрать информацию о книгах оказалось только половиной задачи. На сайте должны были появиться ещё герои, отзывы и цитаты – и всё это нужно было не просто найти, а превратить в нормальные данные: вычистить, проверить, убрать дубли и правильно связать между собой.
Причём если для книг хотя бы существовали более-менее структурированные источники на литературных площадках, то дальше становилось только веселее.
Герои
Лёгких путей мы не искали, поэтому начали сразу с задачи со звёздочкой.
Изначальной выборки героев не существовало вообще.
Когда я писала и публиковала книги, мне почему-то не пришло в голову вести нормализованную таблицу:
«Имя персонажа → книга → серия → роль → варианты имени → описание».
Удивительно, правда?
А потом книг стало около тридцати, и внезапно для сайта понадобился каталог героев.
То есть здесь уже нельзя было взять существующие данные и привести их к общей структуре. Сначала нужно было создать сам dataset, которого никогда не существовало.
Кого считать героем, достойным отдельной страницы? В какой книге он основной, а в какой второстепенный? Как не создать двух персонажей из одного человека, если где-то указано полное имя, а где-то только имя? Как проверить канон? Как связать всё это с сериями?
ИИ великолепно умеет перелопачивать большой объём материала и собирать предварительную структуру. Но сначала кто-то должен ответить на все эти вопросы.
И только потом можно сказать: вот правила – теперь примени их к тридцати книгам.
То есть GPT-5.6 Sol, Instant я снова отдала не принятие решений, а самую объёмную часть работы: применение уже принятых решений к большому массиву данных.
Дубли
Следом появились дубли.
Когда данные приезжают из нескольких источников, недостаточно сравнить одинаковые строки: одна и та же книга или герой могут называться немного по-разному и иметь разный набор метаданных.
Поэтому сначала нужно определить правила, по которым две записи вообще считаются одной сущностью, а уже потом поручать ИИ найти потенциальные совпадения, сопоставить их и объединить данные.
Отзывы
Отдельным этапом стал сбор читательских отзывов.
Их тоже недостаточно просто получить с площадок: нужно привязать к правильным книгам и сериям, нормализовать, найти повторы, удалить мусор, а главное – решить, что вообще имеет смысл показывать на собственном авторском сайте.
Особенно прекрасен в этом смысле ЛитРес: технически API может честно отдать публичный отзыв. А ты читаешь его и думаешь: а зачем мне это импортировать к себе на сайт?
ИИ может собрать тысячу отзывов, классифицировать их и подготовить предварительную выборку. Но решение «это я хочу показывать читателям, а это нет» – уже редакционное.
Его принимаю я.
Цитаты
А потом выяснилось, что цитаты – это тоже данные.
Их надо извлечь, проверить, определить говорящего, привязать к книге, убрать повторы и выбрать те, которые вообще стоит показывать.
А ещё не размножить одну цитату в трёх местах сайта, а сохранить её один раз и связать так, чтобы она могла появляться у книги, героя и серии.
Очередное:
«Да там просто цитатки вывести».
Нет, ребят. В этом месте я перелопатила половину архитектуры, потому что хорошая мысля приходит опосля.
И вот теперь осталось только импортировать
Это была моя любимая ошибка.
К этому моменту данные собраны. Архитектура есть. WordPress работает.
Ну всё, казалось бы. Осталось только импортировать данные.
И неожиданно импортер стал самым прожорливым по времени этапом всего проекта.
Его писали Grok 4.7 High и Grok 4.6 Medium Fast, работа заняла примерно два дня.
Потому что «импортировать данные» на практике означает решить ещё несколько маленьких вопросов.
Например:
- Source of truth. Где находится эталонное состояние данных?
- Идемпотентность. Что произойдёт, если запустить импорт второй, третий или десятый раз?
- CREATE / UPDATE / UNCHANGED. Что надо создать, что обновить, а что вообще не трогать?
- Связи. Что делать, если книга ссылается на героя, серия – на книгу, а всё это создаётся в одном процессе?
- Таксономии. Когда создавать новый термин, а когда использовать существующий?
- Изображения. Как загружать их и не плодить копии?
- ACF. Какие поля и в каком формате обновлять?
- Ручные изменения. Какие данные WordPress имеет право перезаписать автоматически, а какие пользователь мог изменить вручную?
- Dry-run. Как сначала посмотреть, что импортер собирается сделать, не изменив сам сайт?
В какой-то момент нормальный запуск начал выглядеть примерно так:
DRY-RUN. Dataset — source of truth. WordPress не изменяется
А дальше:
TERM авторская раса — UNCHANGED
TERM антигерой — UNCHANGED
TERM боевая героиня — UNCHANGED
И сотни других проверок.
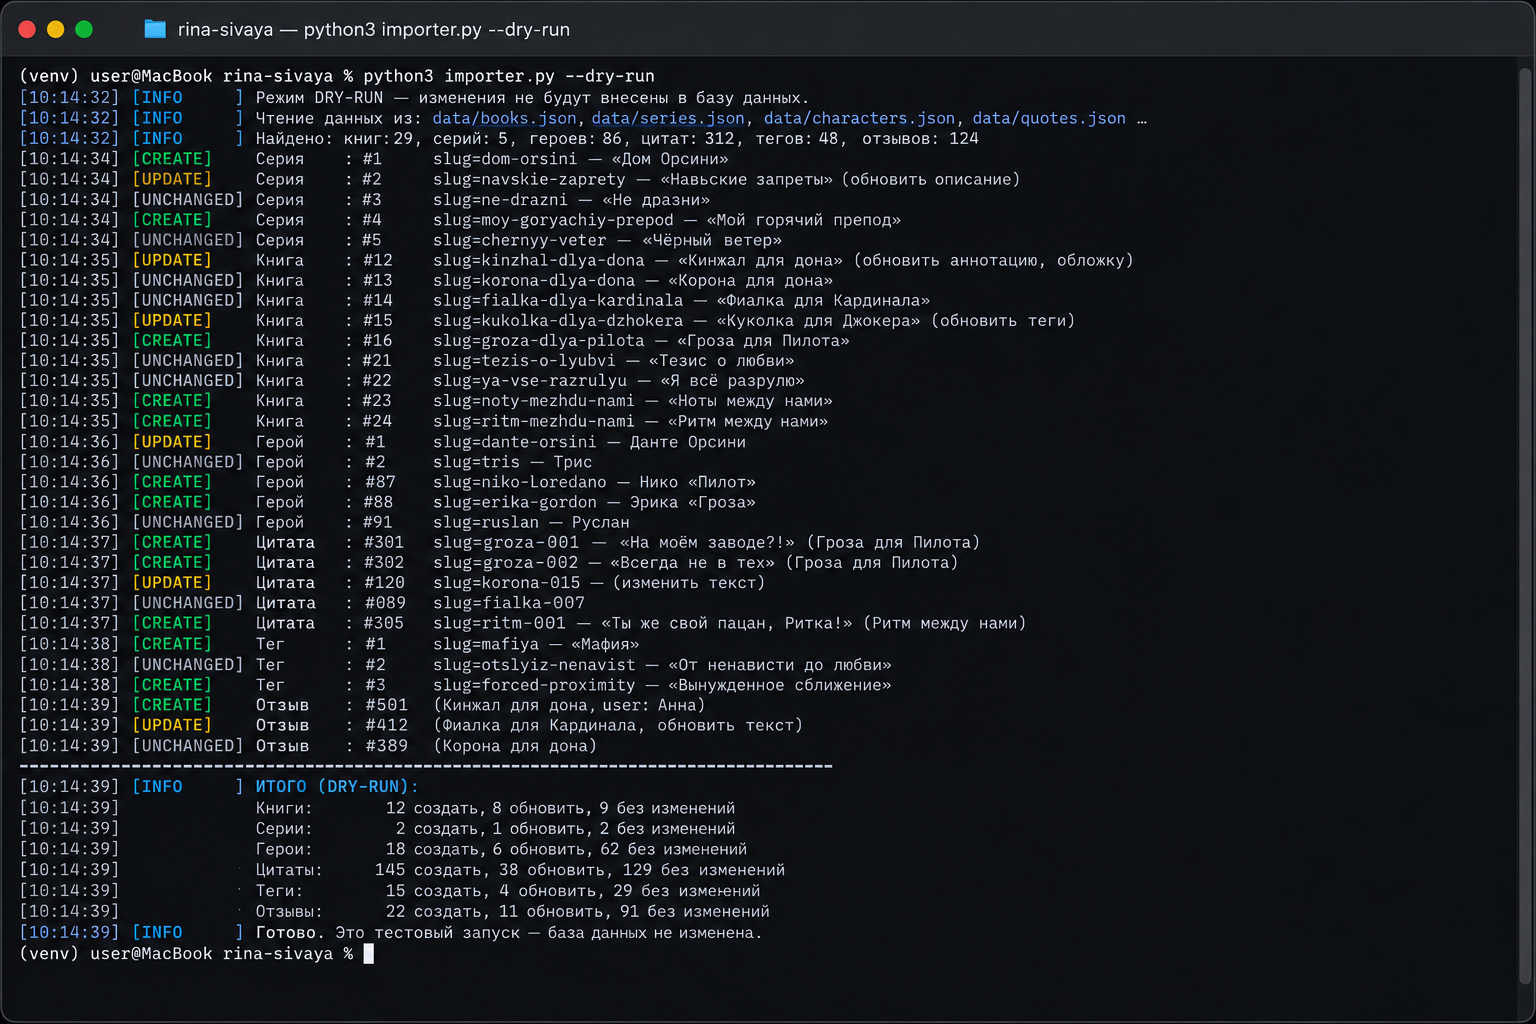
Потом запускаешь это ещё раз – и находишь очередной пограничный случай. Потом ещё один. А потом ещё.
И здесь особенно хорошо понимаешь, что
ИИ очень быстро пишет код, но он не отменяет сложности инженерной задачи.
В некотором смысле происходит даже обратное.
Раньше между мной и очередной архитектурной проблемой лежали несколько часов написания кода.
Теперь код появляется почти мгновенно – и я гораздо быстрее добираюсь до настоящей проблемы, которую решать все равно приходится мне.
Результаты
Самый главный вывод: ИИ не избавил меня от работы
Это важный момент.
Я не сидела несколько дней, наблюдая, как нейросети сами строят мой сайт.
Моя работа просто переместилась на другой уровень:
- формулирование требований;
- проектирование правил;
- обсуждение архитектуры;
- выбор решения;
- проверка визуала;
- тестирование и поиск ошибок;
- смена постановки задачи;
- составление и уточнение промтов для агентов;
- анализ реальных данных и обнаружение случаев, которые не были предусмотрены;
- принятие решений, когда результат правильный, а когда модель уверенно сделала какую-то ерунду.
И вот это применение ИИ я люблю особенно сильно:
Не «напиши вместо меня книгу, а забери у меня нафиг три часа тупой механической работы, пока я принимаю решения.
Для меня это и есть главное преимущество всей этой истории.
Я не хочу отдавать машине решения, которые мне интересно принимать самой.
Я хочу отдать ей работу, которую мне неинтересно делать руками.
Могла бы я сделать этот сайт сама?
За исключением дизайна – да.
Я программист, и большая часть использованных здесь технологий для меня не является магией.
Но если оценивать весь проект целиком и работать над ним безвылазно, я бы заложила примерно две недели собственной работы.
С ИИ некоторые этапы ужались радикально:
- дизайн – около 10 минут;
- архитектура – около 30 минут вместе с обсуждением;
- WordPress-тема – около 15 минут;
- сборщик – примерно полдня с учётом всех итераций;
- герои, отзывы и цитаты – примерно день;
- импортер – примерно два дня.
При этом сравнивать эти цифры напрямую тоже неправильно. Какие-то из них можно было выполнять параллельно, какие-то – буксовали, потому что требовалась связка с предыдущим.
И в итоге получилось, что каждый следующий этап порождал новые требования к предыдущим.
Это не линейный конвейер.
Типичная разработка.
Сколько это стоило
Сразу скажу, что красивой цифры у меня нет.
Я использовала несколько моделей и инструментов, часть – по подписке. Точный расход лимитов и кредитов задним числом восстановить невозможно, поэтому писать что-нибудь вроде «я сделала сайт за 20 долларов» было бы просто враньём.
Зато я могу довольно хорошо оценить другую стоимость – собственное время.
И для меня разница между условными двумя неделями ручной разработки и несколькими днями работы в роли архитектора, постановщика задач и тестировщика гораздо интереснее стоимости нескольких миллионов токенов.
А когда сайт будет закончен?
Никогда.
И это тоже пришлось принять.
Можно бесконечно улучшать архитектуру, добавлять новые связи и переделывать каталог. Заниматься SEO, искать ещё отзывы, ещё цитаты. Перепроверять старые книги.
А есть работа, которую вообще невозможно полностью переложить на ИИ: например, арты.
У меня накопилось множество иллюстраций к разным историям. Импортер прекрасно сможет взять подготовленные файлы, загрузить их в WordPress и связать с нужными книгами и героями.
Но сначала кто-то должен открыть мои архивы, найти эти арты, понять, к какой истории относится каждый, выбрать лучшие и решить, что я хочу видеть на сайте.
Этот кто-то – я.
А потом я выкладываю на площадки новую книгу, и все начинается заново.
Поэтому в какой-то момент критерий готовности пришлось изменить.
Не «на сайте больше нечего делать» – такого момента не будет.
А «сайт уже выполняет задачу, ради которой я его делала».
Всё остальное можно добавлять постепенно.
Так можно ли сделать сайт с ИИ?
Можно.
Но если нужен не пятиэкранный прототип для красивого скриншота, а настоящий рабочий продукт, магической кнопки всё ещё нет.
- ИИ может нарисовать дизайн.
- Может сверстать.
- Может написать WordPress-тему.
- Может спроектировать вместе с вами архитектуру.
- Может перелопатить десятки книг, найти героев, собрать отзывы, нормализовать данные и написать импортер.
Но кто-то всё равно должен решить:
- что именно мы строим;
- какие данные считаем правильными;
- что делать с исключениями;
- какой результат нас устраивает;
- и когда уже, наконец, пора перестать допиливать сайт и заняться чем-нибудь ещё.
В моём случае искусственный интеллект не заменил разработчика.
Он позволил разработчику гораздо меньше времени быть кодером, верстальщиком и контент-менеджером – и гораздо больше времени заниматься архитектурой, постановкой задач и принятием решений.
Ну и книжки писать, куда уж без этого 🙂
Мог ли всё это сделать не разработчик?
Да. И, пожалуй, это один из самых интересных выводов всего эксперимента.
С современным ИИ человек без опыта разработки действительно может собрать полноценный авторский сайт – не просто страницу с фотографией, биографией и ссылками на книги, а каталог, серии, карточки героев, фильтры, поиск и другие довольно сложные вещи.
Но есть важная оговорка:
ИИ сильно снижает порог входа в разработку, но не отменяет необходимость принимать решения.
В моём случае результат во многом получился таким именно потому, что за плечами у меня одиннадцать лет веб-разработки. Я понимала, как должна быть устроена информация, какие сущности лучше разделить, какие связи заложить между ними, что должно редактироваться из админки, а что формироваться автоматически. Могла заранее задать правила, заметить неудачное архитектурное решение и объяснить ИИ не только что сейчас не работает, но и как это должно работать в системе целиком.
ИИ при этом проделал огромную часть непосредственной работы. Но он не принимал за меня главное решение – что именно мы строим.
Поэтому не разработчик вполне может повторить такой путь. Просто его диалог с ИИ, скорее всего, будет другим: больше итераций, больше проб и переделок, больше решений, которые придётся находить уже в процессе.
И, наверное, именно здесь проходит новая граница. Чтобы сделать свой сайт, теперь необязательно уметь написать его код самостоятельно. Но чем лучше ты понимаешь, что хочешь построить и почему это должно работать именно так, тем больше пользы сможешь получить от ИИ.
А результат эксперимента можно посмотреть вживую:
Комментарии
Написать комментарийВойти